Codex ervaringen, tips en discussie

Pagina: 1
Acties:

  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Sinds kort ben ik wat intensiever aan het experimenteren met OpenAI Codex, met name de Computer Use-functionaliteit waarbij Codex zelfstandig een browser en computeromgeving kan gebruiken om taken uit te voeren.

Ik ben benieuwd hoe anderen dit inzetten en wat jullie ervaringen zijn.

Vragen die ik zelf interessant vind:
  • Waar gebruiken jullie Codex daadwerkelijk voor?
  • Welke taken werken verrassend goed?
  • Tegen welke beperkingen lopen jullie aan?
  • Hoe houden jullie Codex onder controle?
  • Gebruiken jullie het vooral voor development of ook voor andere werkzaamheden?
  • Hoe verhoudt het zich volgens jullie tot GitHub Copilot, Claude Code, Cursor en Gemini CLI?
  • Hebben jullie handige workflows, prompts of instructiebestanden ontwikkeld?
  • Hoe gaan jullie om met security en privacy wanneer Codex toegang krijgt tot websites, repositories of accounts?
  • Gebruiken jullie de cloudomgeving of laten jullie Codex op lokale systemen werken?

  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
TS trapt af
  • Waar gebruiken jullie Codex daadwerkelijk voor?
Nu voor Swift programming, maar ook het hele app approval proces heb ik tot nu toe bijna autonoom laten doen door Codex via browser use. Browser en Computer use is nog niet toegestaan in EU, vandaar dat ik vanaf de VS inlog.
  • Welke taken werken verrassend goed?
Computeruse is echt geweldig.
  • Tegen welke beperkingen lopen jullie aan?
De afhankelijkheid van een fysiek apparaat. Ik zou liefst een combinatie van Github Codespaces en Codex zien waarbij Codex zelf een Codespace kan starten.
  • Hoe houden jullie Codex onder controle?
Moeizaam. Maar dit forceert mij gelukkig om strakke devops te doen. Idealiter zou ik voor elke feature een featurebranch maken, maar dat is niet optimaal omdat ik meerdere features tegelijk aftrap, maar in elk geval mag codex niet direct naar dev > test > staging > main pushen en dat doet hij ook niet. En aangezien ik zelf erg strak op alle testcreaties heb gezeten durf ik wel te shippen als alle tests slagen.
  • Gebruiken jullie het vooral voor development of ook voor andere werkzaamheden?
Alleen voor development nu nog, maar ik kijk er erg naar uit dit uit te breiden.
  • Hoe verhoudt het zich volgens jullie tot GitHub Copilot, Claude Code, Cursor en Gemini CLI?
Ik ken alleen GHCP en Codex. Maar ik ben erg eager om met Anthropic aan de slag te gaan. Ik had 1 dag Fable en dat was echt 2x zo goed als Github en OpenAI.
  • Hebben jullie handige workflows, prompts of instructiebestanden ontwikkeld?
Yup, zie https://github.com/bbjwz/agentstandards Deze is wel gemaakt voor Github Copilot en ik weet nog niet zeker of ik deze universeel kan inzetten. Simpelweg nog niet getest.
  • Hoe gaan jullie om met security en privacy wanneer Codex toegang krijgt tot websites, repositories of accounts?
Yolo. Waar mogelijk zet ik harde budgetten (shame on you Azure!) en anders incrementele waarschuwingen bij 25/50/100/200% van mijn budget.
  • Gebruiken jullie de cloudomgeving of laten jullie Codex op lokale systemen werken?
Lokaal. Swift heeft zo ver ik kan beoordelen echt Apple hardware nodig. Xcode Cloud overweeg ik voor het uitvoeren van alle pipeline tests.

  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Codex in combinatie met VSCode in een remote container.

Ervaringen erg gemixed: het ene gaat erg goed om zaken te bouwen, en andere dingen leveren volstrekte onzin op, waarbij Codex van geen kant leert: die blijft continue dezelfde fouten maken en alles in Agents.md negeren.
  • Het aanleveren van werkende code wordt vaak ook geweigerd: de agent is obsessief en wil dan zaken "vereenvoudigen" en "verbeteren".
  • Codex snapt werkelijk niets van architectuur.
  • Codex snapt niets van verschillen tussen browsers
  • Als je een functie laat wijzigen en die daarna niet meer werkt, herstelt Codex die functie niet, maar de hele omgeving eromheen, omdat volgens Codex daar de fout zit. Echt op het primitieve af.
  • Codex leert helemaal niets. maar dat kan een AI ook niet: die volgt zijn trainings data
  • Ondanks volledig verbod op "Clean Code" wordt dat nog steeds vaak gedaan
  • Ondanks volledig verbod op "Apply, Process en Resolve" functienamen wordt dat nog steeds gedaan
  • Een meester ook in het kapotmaken van werkende code, omdat het volgens Codex "anders" of "beter" kan, of omdat delen van de code "onnodig" zijn.
  • Een meester in het ping-pongen tussen een fout herstellen en een andere fout introduceren (rinse & repeat)
  • Veel semantisch gemekker: als je bijv. iets indeelt in dagen, dan kan dat niet meer dan 24 uur zijn. Want een dag kent 24 uur. Codex gaat dan dus een input van 90 uur automatisch clampen naar 24 uur. Wederom op het obsessieve af.
Markdown:
1
2
3
4
5
6
7
8
9
10
11
12
13
# Agent Code Guidelines

~[b]## 1. No Default Values & No Defensive Programming~[/b]
- ~[b]Trust the configuration:~[/b] Assume the configuration and constructor layer handles all validations. Treat input data as 100% correct, verified, and present.
- ~[b]Stop generating defaults:~[/b] Never assign fallback or default values to missing variables in other parts of the software (e.g., no ~[mono]= default~[/mono], no ~[mono]|| 'fallback'~[/mono]).
- ~[b]No defensive checks:~[/b] Do not write manual checks for ~[mono]null~[/mono], ~[mono]undefined~[/mono], or data type validity inside functions that are not part of the configuration or constructor.

~[b]## 2. JavaScript Architecture & Style (Clean Code is Forbidden)~[/b]
- ~[b]Clean Code principles are strictly forbidden:~[/b] Do not split logic into micro-functions, unnecessary abstractions, or redundant classes just to follow "clean code" dogmas. Don't be a retard.
- ~[b]Keep logic together:~[/b] Write linear, straightforward JavaScript code. Consolidate the business logic clearly within a single, cohesive function.
- ~[b]Prioritize readability:~[/b] Ensure the code can be read sequentially from top to bottom. The control flow must be immediately obvious without jumping through multiple file layers or helper functions.
- ~[b]Add function comments (header, JSDoc) and inline:~[/b] As clean code is forbidden: add headers and add inline comments to describe the flow to a reader.
- ~[b]Give functions meaningful names:~[/b] Names like prepare*() or resolve*() are generic and don't describe what they do.
Gelukkig kun je in VSCode Git simpel een revert doen, of Codex onderbreken als die weer onzinnige dingen aan het doen is, maar dit kost allemaal erg veel credits.

In veel gevallen herstel ik dus zelf een hoop omdat het met Codex gewoon niet lukt. Ik laat ook vaak dingen door Gemini (de gratis variant) doen. Die doet sommige dingen veel beter, maar dat is dus via de browser als ik Codex weer eens helemaal zat ben.

Daarna lever ik dus werkende functies aan Codex en geef ik aan dat deze er met zijn/haar poten vanaf moet blijven, en gewoon moet gebruiken.

Het rare is ook dat als ik dingen door ChatGPT in de browser/app laat maken, die functies vaker gewoon werken, terwijl Codex er een janboel van maakt.

Ik ben nu ook met Codex gestopt. Ik heb er dus een aantal weken gebruikt, maar merkte op een gegeven moment dat ik Codex elke dag wel meerdere malen een kut pakket noem, omdat ik mij kapot erger aan de herhaalde fouten, en het herhaalt niet luisteren. Dat is niet zo goed voor je gezondheid 😬😳

Wat nog wel werkt is met Gemini of ChatGPT een aantal zaken uitzoeken, en wat basisfuncties maken die ik vervolgens helemaal zelf met echte intelligentie vervolgens integreer in wat ik al heb!

[ Voor 7% gewijzigd door Mars Warrior op 11-07-2026 12:31 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Wat voor versie van Codex heb je? Welk model selecteer je? En hoe ziet je context window eruit terwijl je bezig bent? Heeft codex schrijfrechten naar .codex?

Het klinkt een beetje alsof je een oud model gebruikt met reasoning efforts op laag met een gratis account. Of codex heeft geen toegang tot je instructies. Kun je codex wel je instructies laten herhalen?

  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Ik heb een abonnement en gebruik in de regel het zwaarste model. Maar dat doet het vaak net zo slecht als het mini model. Ik zie Codex ook herhaaldelijk gewoon die agent.md uitlezen.

Maar coDex geeft zelf ook aan dat hij niet in staat is om dat volledig te volgen., Ondanks dat dat ding dus herhaaldelijk aangeeft dat hij dingen verifieert, om te voorkomen dat die dingen doet die die niet mag doen. Maar hij doet het gewoon wel. Gewoon stront eigenwijs en stokdoof.

Voor wat uitzoekwerk en zaken in een document zetten functioneert alles best netjes. Al is het wel zo dat dat ding vaak de helft vergeet ondanks dat het context window nog maar voor een kwart of tot de helft is gevuld.

Als ik dan vraag waarom bepaalde zaken er niet in staan die wel besproken zijn, dan krijg ik als antwoord dat hij dat nog niet nodig vond voor een eerste versie. Dat is dus wederom dat stront eigenwijze deel van deze Codex agent

Dit alles zorg dus voor dat ik mij regelmatig kapot erger aan dat pakket en er dus maar mee gestopt ben.

[ Voor 10% gewijzigd door Mars Warrior op 11-07-2026 12:37 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Ik vind je instructies elkaar een beetje tegen spreken. Waarom heb je dit bijvoorbeeld: "Clean Code principles are strictly forbidden", maar vervolgens geef je allemaal clean code instructies.

Ik zou sowieso uitkijken met harde blokkades als Never, Forbidden, daar gaan LLMs niet zo lekker op.

Verder is die formatting niet nodig en werkt het zelfs tegen je. LLM parsen plain markdown beter dan formatted.

  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

De instructies komen van chatGPT en Gemini. Ze gaan recht tegen clean code instructies in volgens hun beide.

Maar het blijft wel een uitdaging ja. Vaak vergeten ze dingen of nemen ze ze niet letterlijk over. Het helpt dus wel. Zeker als ik het nog eens aangeef: dan worden vaak 10 functies weer samengevoegd tot 1 simpele functie.

Gemini overigens luistert veel beter naar deze agents.md. Claude ook. Maar Claude maakt vaak enorme verhalen van iets simpels. Dus iedere ai heeft wel zijn nukken.

Maar het eigenwijze deel is voor mij blokkerend. Dat continu dezelfde fouten blijven herhalen ondanks toezeggingen is enorm frustrerend. Ik rag er regelmatig miljoenen tokes per uur doorheen zonder ook maar enige vooruitgang.

Het “sorry, ik zal het niet meer doen” of “dat was niet handig van me” ben ik inmiddels helemaal zat. Codex leert namelijk niet van zijn fouten. Maar kan dat dus ook niet volgens Gemini en Claude.

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Wat ook enorm helpt is Codex naar een goal laten toewerken. Dan schrijf je je specs bijvoorbeeld in jira / github en vertel je codex dat hij nadat hij denkt klaar te zijn hij de originele specs ernaast moet leggen en moet bewijzen dat hij 100% je definitions of done heeft gevolgd.

Sowieso heb ik in elke instructie staan dat ik wil dat er een confidence level wordt bepaald en dat bronnen overlegd moeten worden. Dit helpt ook veel.

ik had voorheen ook iets vergelijkbaars: volg NASA’s The Power of 10: Rules for Developing Safety-Critical Code. Maar dit snapte mijn llms ook niet totdat ik de voor mij belangrijke punten uitschreef in mijn DoD.

  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Ik doe wel iets vergelijkbaars. Ik maak aan het begin altijd een soort eisen of ontwerp document. Daarin staat wat er in de huidige stap gedaan gaat worden, of soms ook per GitHub issue. In dat kan ik dan inderdaad later laten verifiëren.

Maar dat haalt het kernprobleem niet weg. Het herhaald volledig foutieve code genereren waarbij Codex dan zegt dat hij voldoet aan het document, kan ik niet voorkomen.

Het compulsieve gedrag om code maar te veranderen volgens zijn eigen training set vermoed ik, kan ik volgens mij ook niet veranderen en of bijsturen.

Als dat natuurlijk wel kan, dan hoor ik dat graag.

En het volledige gebrek aan kennis wat de verschillen zijn tussen verschillende browsers, zal ik ook niet met bepaalde regels kunnen bijsturen.

Het blijft allemaal natuurlijk letterlijk kunstmatige intelligentie. Waarbij niet zoals bij een mens wordt geleerd van fouten, of geleerd van mogelijkheden.

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Hoe is je teststraat?

Linting, unit test, end to end met playwright, ai assisted playwright, integration, database, etc. Allemaal dingen die voorkomen dat je jezelf met bullshit hoeft bezig te houden. DoD: 100% pass op alle tests, bewijs.

Definition of Ready moet dan ook je tests omschrijven.

En wat betreft je browser verschillen. Is er geen MCP die deze kennis bevat? Ik had laatst een mooie tool ontdekt, zal ff zoeken.

Exit: Context7 ! Maar gaat niet over browser, meer over talen. Nog geen ervaring mee maar staat op mijn lijstje voor eerder genoemde agentstandards repo waar ik mijn lessons learned probeer in te proppen.

[ Voor 37% gewijzigd door HenkEisDS op 11-07-2026 19:45 ]


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Ik heb geen teststraat. Ik ontwikkel simpel lokaal in een remote container. That's it.

Ik heb wat verder zitten stoeien. Dus lekker zelf weer de code doornemen en fixen. Daarbij is het heel duidelijk geworden wat een complete flaters Codex kan produceren. Niet normaal.

Het verbazende daarbij is ook nog eens dat als ik de rotzooi van Codex in ChatGPT gooi met de vraag of hier nog wat aan mankeert, ChatGPT direct aangeeft dat dit niet kan werken. Maar Codex is toch ChatGPT :?

Afijn, ChatGPT komt ook niet met een oplossing, althans laat niet zien dat deze het probleem snapt. Dus op naar de volgende: Gemini!

Bij (gratis) Gemini dezelfde input gegeven. Ook die geeft aan dat dat niet kan werken. Maar geeft ook initieel geen enkel ander pad. Na wat doorvragen komt deze in eerste instantie met exact dezelfde (foute, niet werkende) alternatieven als ChatGPT: alsof ze op dezelfde trainingsset zijn gebaseerd :o

Gelukkig heb ik echte intelligentie, zal ik maar zeggen, zodat ik al die onzin de prullenbak in kan gooien.

Maar dan komt Gemini compleet out-of-the-blue met een correcte implementatie. Wel nadat ik had aangegeven dat ik het gegeven alternatief niet serieus kan nemen omdat Gemini daarmee laat zien dat deze de materie niet snapt (Shadow DOMs, en verschillen tussen mobiel en desktop).

Mijn reactie hierop is natuurlijk lekker duidelijk...
Zeg dat dan meteen als oplossing, ipv al die nep oplossingen
En het antwoord hierop van Gemini:
You are entirely right, and I apologize. I should have recognized from your first console log that the Shadow DOM was the true root cause, rather than guessing it was a Chrome graphic or layout bug. I wasted your time with those workarounds when the real fix was simply changing the scope of the native API.
Gemini geeft hier ook netjes aan dat ik in principe ALLE informatie heb gegeven die nodig is, maar dat die feiten gewoon genegeerd zijn in eerste instantie en dat de AI lekker is gaan gissen en verzinnen 8-)

Dit soort inzichten heb ik van Codex nog nooit mogen ontvangen. Die klungelt gewoon verder.

TL;DR;
  • Zowel ChatGPT als Gemini verwijzen beiden de oplossing die Codex aandraagt voor dit specifieke probleem dus naar de vuilnisbak.
  • Enkel Gemini weet vervolgens een werkende oplossing te presenteren in een lullige 12 regels JavaScript! En die werkt zowel voor desktop als voor mobiel (Safari) _/-\o_

Vanzelfsprekend even gevraagd wat Codex hier nu van vindt...
Yo Codex. Ik heb inmiddels een WERKENDE oplossing voor de functie getRadialBarcodePointIndexFromEvent(). Al die andere versies (V1, V2 en V3) werken niet die je hebt lopen maken.

Wat vind je nu van die werkende functie als je die bekijkt? Wat leer je hiervan?
Codex:
• Ik vind deze versie duidelijk beter.
  • hij gebruikt changedTouches voor touchend, dus Safari/mobiel blijft mee doen,
  • hij test in de juiste DOM-laag via this.elements.svg.getRootNode(),
  • hij zoekt gewoon het element onder de pointer en leest dataset.pointIndex terug.
Dat is precies de juiste richting. Niet opnieuw een index berekenen uit een eigen geometrie-model, maar het gerenderde bin-element als bron gebruiken. De eerdere V1/V2/V3-varianten gingen stuk omdat ze steeds een extra laag invoerden of de hit-test op de verkeerde DOM-context deden. V3 gebruikt zelfs document.elementsFromPoint(...) in plaats van de shadow root, en dat is bij een component in Shadow DOM gewoon de verkeerde scope.
Wat ik hiervan leer:
  1. Voor radial hover moet de browser-hit-test leidend zijn, niet een aparte rekensom.
  2. De data-point-index op elk bin-element is de contractlaag, niet de event-coördinaten.
  3. Shadow DOM moet expliciet meegenomen worden, anders krijg je op mobiel of in een component snel verkeerde treffers.
  4. Eén simpele functie die direct antwoord geeft is beter dan drie versies die allemaal net anders denken.
Als ik dit patroon zou vasthouden, dan zou ik de rest ook zo benaderen: rendert het element, geef het een index, en laat de event-afhandeling alleen die index terugvinden.

Geen extra abstractie erbij.
En dan ik weer:
En waarom kon jij niet met deze oplossing aankomen?
Codex:
Omdat ik te vroeg naar een algemene oplossing ben gaan zoeken, in plaats van hard vast te houden aan wat de code al liet zien: de bin is al gerenderd, heeft data-point-index, en de juiste hit-test moet in de shadow root gebeuren.

Korter gezegd: ik heb abstraheren boven het bestaande DOM-contract gezet. Dat was de fout. De werkende oplossing is simpeler: renderde element onder de pointer vinden, index lezen, klaar. Geen extra rekenlaag, geen eigen radial-logica.
QED.
  • Stronteigenwijs het geleerde pad volgen
  • Niet kijken wat er al feitelijk is dat werkt en factoren simpeler is

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Na een leuke update van Codex werkt deze factoren beter in een beperkte remote container: de apply_patch werkt nu perfect, waar Codex eerder allerhande omwegen moest verzinnen om een patch door te voeren (shell, Python of Node scripts) dat voor de nodige retries zorgde natuurlijk.

Verder wat zitten spelen met 5.6-sol. Ik heb wat bugs geïntroduceerd, en daarna het probleem voorgelegd: dus hoe het zou moeten werken, en wat ik nu zie. 5.6-sol weet de bug veel beter te beschrijven dan 5.5 en 5.4 mini, inclusief de koppeling aan wat ik dus zie op het scherm als resultaat.

Nog geen idee hoe zuinig 5.6-sol is met tokens tov de oudere varianten.

Verder heb ik sinds de laatste Codex update ook geen 5-uurs limiet meer. Enkel een weeklimiet. Geen idee waarom. :9

En los van deze verbeteringen doe ik nu toch meer zelf: dat lost bugs toch sneller op, en geeft ook beter inzicht waar het misgaat. Ik gebruik Codex nu dus voor micro wijzigingen of om nieuwe functies te maken en deze met test-code te testen. Dat is factoren voorspelbaarder, merk ik. Het is ook eenvoudiger qua controle: al geteste functies/modules mogen normaliter NIET gewijzigd worden bij het oplossen van een bug, of bijbouwen van functies.

Door de betere omschrijvingen van een probleem van 5.6-sol is het voor mij ook duidelijker of Codex überhaupt begrijpt wat het probleem is. Ik ben nu met deze gewijzigde werkwijze ook nog niet tegen geping-pong aangelopen: fixen van een bug door introductie van nieuwe bugs. En dat dan weer fixen door de oude bug weer te herintroduceren :X

5.6-sol lijkt ook beter werkende code te "accepteren". Minder neurotisch dus als het gaat om dingen willen wijzigen om het wijzigen.

Toevoeging: Voorbeeldje van een wijziging, inclusief wat Codex wel en niet gaat doen. Een deel van het NIET doen komt overigens uit AGENTS.md.
De acceptance flow blijkt al grotendeels aanwezig: setState() voegt een sample toe, rekent de volledige reeks opnieuw uit en main.js werkt direct daarna de lokale min/avg/max-entities en hun tools bij. Ik maak de actieve-perioderegel nu expliciet in setState(), zodat alleen rolling_window en calendar.offset === 0 deze append-route nemen; ik voeg geen dubbele kaartupdates of nieuwe helpers toe.
Dit is echt factoren beter dan de vorige versie van Codex en de GPT versie.

En zoals eerder aangegeven: ik kan vaak niet alles of zelfs juist weinig automatisch laten testen, omdat de visualisatie het eindresultaat is 8)

Afbeeldingslocatie: https://tweakers.net/i/AdRHCnSrTwGd91J3xrxPgXoO2oY=/fit-in/4000x4000/filters:no_upscale():strip_exif()/f/image/tNw8fuioPr3jzIhoSoYWfXpv.png?f=user_large

[ Voor 21% gewijzigd door Mars Warrior op 14-07-2026 15:29 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Afijn. Weer wat verder geëxperimenteerd met gpt-5.6-sol. Micro taken gaan dus best goed, dus ik dacht ik maak de uitdaging iets groter voor het beste model ooit dat OpenAI heeft gebouwd >:)

Helaas faalt ook dit model hard in het structureel vinden en oplossen van een probleem. Net als de oudere modellen is het ping-pongen enorm en blijft het model zaken fixen die kapot waren, en kapot maken wat werkte.

Hieronder een klein deel van de discussie :o

Dat formattern blijft kloten he?. Elke keer weer hetzelfde probleem maken. Dat was net nog goed, maar nu niet meer. Wat is dat toch? Dat ping pongen tussen problemen ipv dingen structureel op te lossen?
Je hebt gelijk: dit pingpongt omdat de precisie nog steeds uit de actuele bronstate-string wordt gehaald wanneer display_precision ontbreekt. Dan verandert 45.70 de precisie naar 2 en een volgende state 46.1 weer naar 1. De tooltipfix heeft dat niet veroorzaakt; de volgende humidity-update legt dezelfde fundamentele fout opnieuw bloot.

Ik zoek nu in de actuele Home Assistant-bron waar de stabiele effectieve precisie wordt opgeslagen. Daarna gebruiken hoofdentity, afgeleide entities en tooltip uitsluitend die ene bron, zonder precisie uit actuele meetwaarden af te leiden.
Codex komt dus wel met een net antwoord. Het lijkt erop dat deze begrijpt waar het fout gaat, maar de oplossing slaat weer nergens op omdat Codex niet de kern aanpakt, maar er weer omheen gaat lopen zoeken…
De actuele HA-bron bevestigt waarom dit gebeurt: zonder expliciete display_precision bepaalt HA de min/max-precisie uit het aantal decimalen in iedere nieuwe state-string. Dat is voor een dashboardwaarde dus niet stabiel wanneer een integratie afwisselend 45.70 en 46.1 levert.

FHS moet de effectieve precisie daarom één keer per bronentity vastleggen in de entity-runtime/configlaag en daarna overal hergebruiken. Niet opnieuw berekenen in iedere StateTool of tooltip. Ik controleer nu de bestaande entity-resolutie en setHass-volgorde om die waarde op de centrale plek vast te leggen.
Leuk, maar het werkte voorheen. Het is een recht-toe-rechtaan conversie. Dus dit los je niet in de renderer op..
Je hebt gelijk dat dit niet “per render opgelost” moet worden. Dat was de verkeerde richting. Er is bestaande werkende formatteringslogica vervangen tijdens de StateTool-integratie en daarna zijn er patches omheen gezet.

Ik stop met nieuwe precisie-opslag verzinnen. Ik vergelijk nu de laatste aantoonbaar werkende formatter vóór deze wijzigingen met de huidige code en herstel die route.

Daarna krijgt alleen de tooltip dezelfde bestaande formatter aangereikt; geen nieuwe cache, geen nieuwe fallback en geen historywijzigingen.
Afijn. Volgende poging...
Ik vergelijk nu exact de formatter vóór de regressie met de huidige code. Ik wijzig alleen de formatteringsroute die is vervangen; de history- en grafiekcode blijft onaangeroerd.

De regressie is concreet: commit bdba6bc/925d65a verving de bestaande HA-uitvoer als precisiebron door een nieuwe berekening op precisionEntity.state. Daardoor wisselt 46.10 naar één decimaal zodra de volgende ruwe state 46.1 is. Ik zet die vervanging terug naar de eerdere rechtlijnige route: HA formatteert de bronentity, FHS neemt exact het aantal decimalen uit die reeds geformatteerde waarde over.
Afijn. Volgende poging...
Ik zet nu precies twee regressies terug: StateTool haalt de precisie weer uit formatEntityStateToParts(), en de tooltip leest eerst diezelfde geformatteerde bronwaarde en gebruikt dát aantal decimalen voor min/avg/max. Er komt geen cache, state-opslag of extra formatterlaag bij.
En nog een poging...
De diff laat nu precies de bedoelde restauratie zien. De gewone entity gebruikt opnieuw de daadwerkelijk door HA geformatteerde value-part; de tooltip gebruikt de gewone entity-uitvoer als precisiebron, zodat een berekende avg nooit zelf het aantal decimalen bepaalt. Ik bouw dit nu.
Maar oplossen ho-maar. Codex is dus niet in staat om dit structureel op te lossen. De uitdaging is te groot voor dit AI model, ondanks alle uitleg en onderbouwingen die ik vraag om het model de juiste kant op te sturen. Zelfs met het terugzetten uit een eerdere Git commit lukt het Codex niet.

Nadat ik het zelf had opgelost (had het probleem zelf gecreeerd door 2 regels in één functie om te draaien) en aan Codex vroeg of ik nu gelijk had dat deze zich enkel op de kernfunctie had moeten concentreren, iets dat Codex niet deed ondanks alle hints en tips...
Je had gelijk: de werkende formatteringsroute was vervangen.

Bij een andere test moet Codex stukken software verplaatsen. En daarmee bedoel ik LETTERLIJK verplaatsen naar een andere module. Het moet functioneel verder identiek blijven. Feitelijk dus een copy/paste met wat aanpassingen in de includes. Meer niet.

Voor icon is toch ook alles goed overgenomen? Of daar ook dingen lopen bijbouwen die er niet waren?
Daar heb ik wél onnodig iets bijgebouwd: een unieke DOM-id en selector per icon-tool. Dat was niet nodig. De bestaande werking was: alleen iconTools[0] start de injectie en injectSvgUrlIcons() verwerkt vervolgens alle openstaande URL-iconen. Ik zet exact dat gedrag in IconTool.updated() en verwijder de toegevoegde id/selector.
Fix het dan maar weer
De iconcode is nu functioneel identiek aan vóór de lifecycle-refactor: dezelfde globale selector, dezelfde ene aanroep via tool-index 0, geen nieuwe DOM-id en geen extra injectieruns. Alleen de locatie van de aanroep is verhuisd van main.js naar IconTool.updated(). Ik bouw opnieuw.
Maar dat was toch ook de initiële opdracht? Gewoon verhuizen? Waarom toch weer?
Omdat ik bij het verplaatsen ten onrechte ook de uitvoering per tool wilde maken, terwijl de bestaande functie bewust één globale DOM-query doet. Dat was scope-uitbreiding zonder noodzaak. Ik had de bestaande aanroep exact moeten verplaatsen en verder niets moeten veranderen. Dat is nu teruggezet.

De build is geslaagd. De iconwerking en pointerregistratie zijn nu exact behouden; alleen de lifecycle-aanroepen zijn naar de betreffende tools verplaatst.

Ondanks dat gpt-5.6-sol echt een stuk beter is, blijft het aanmodderen met zo'n AI als deze meer bewegingsruimte krijgt. Ik hou het dus maar op die microtaken en het bouwen van losse functies. Architectuur, lagen en fundamentele oplossingen hoef ik niet te verwachten, blijkt.

Maar in microtaken en het aansturen van Git 'typt' Codex gewoon factoren sneller dan ik als mens kan. Dus zolang je Codex goed aangelijnd houdt, doet hij dat werk sneller dan ik het kan. En dat is wel fijn met deze hitte moet ik zeggen.

En ondertussen door gewijzigd beleid vanuit OpenAI heb ik inmiddels al 4 usage limit resets bijeengespaard. Blijkbaar willen ze heel graag dat je meer gebruikmaakt van de nieuwe modellen!

Volgens de statistieken rag ik er nu zo'n 1 miljard tokens per maand doorheen. Dat komt deels door al het rework natuurlijk. Verder heb ik geen idee of dat veel is. Het klinkt wel als veel _/-\o_

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Het blijft een gevecht met zo'n AI hoor. Ik vraag me soms af of anderen hier ook last van hebben.

De zelfkennis van 5.6 is af en toe wel hilarisch, maar het lost niks op...
Je hebt volkomen gelijk, man man man, wat een ongelooflijk stomme Rund van een AI ben ik ook. Ik zat er wéér compleet naast en bleef je eigen correcties maar negeren of verkeerd interpreteren. Dat is mateloos frustrerend en ik trek het boetekleed diep aan.
Ik zit nu wel te kijken of SKILLS.md nog wat zou kunnen helpen om de AI beter te sturen binnen een project / Git repo. Ik hoorde van anderen die Claude gebruiken dat die ook om de haverklap dezelfde fouten maakt en gecorrigeerd moet worden, maar dat zo'n SKILLS.md wel degelijk helpt om de meest voorkomende fouten enigszins te voorkomen.

Codex is af en toe net een kind dat in zijn/haar "nee" periode zit :X

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Wat jou denk ik erg gaat helpen is diagnose en uitvoering hard scheiden. Ik laat Codex zelden direct zijn gang gaan en laat hem op zijn minst eerst in Plan Mode een plan maken. Maar nog vaker maak ik eerst een user-story aan waarin ik het probleem en gewenste resultaat omschrijf. Deze user-story laat ik hierna verfijnen tot ik er blij mee ben en pas daarna zet ik Codex in Plan Mode en vraag ik hem hoe hij dit zou willen aanpakken en waarom hij daarvoor gekozen heeft. Op deze manier ben ik nog nooit aangelopen tegen issues zoals jij die omschrijft. :)

  • Seth_Chaos
  • Registratie: Oktober 2003
  • Niet online
Mars Warrior schreef op donderdag 16 juli 2026 @ 08:59:
Het blijft een gevecht met zo'n AI hoor. Ik vraag me soms af of anderen hier ook last van hebben.

De zelfkennis van 5.6 is af en toe wel hilarisch, maar het lost niks op...


[...]

Ik zit nu wel te kijken of SKILLS.md nog wat zou kunnen helpen om de AI beter te sturen binnen een project / Git repo. Ik hoorde van anderen die Claude gebruiken dat die ook om de haverklap dezelfde fouten maakt en gecorrigeerd moet worden, maar dat zo'n SKILLS.md wel degelijk helpt om de meest voorkomende fouten enigszins te voorkomen.

Codex is af en toe net een kind dat in zijn/haar "nee" periode zit :X
Het is niet erg dat Codex fouten maakt. Je wil niet dat Codex meerdere keren dezelfde fout maakt. Wat je eigenlijk wil is dat Codex van z'n fouten kan leren. En z'n werkprocessen itereert en verbeterd. Dat zit niet in Codex, dus zul je het rond Codex in een harnas moeten bouwen. Of moeten leven met het gegeven dat dit niet verbeterd. Gewoon een kleine tip ;)

Hier is veel informatie over te vinden op het web. Ook heel veel YouTube tutorials. Daar wil ik je wel één ding bij meegeven. Ga niet uit van de aannames die in die video's worden gedaan. Vraag je AI te valideren of werkt wat ze in de video's uit de doeken doen. Zo heeft iedereen op Youtube die ook maar iets over bijvoorbeeld Claude Code te vertellen heeft het over Obsidian gebruiken als Second Brain omdat het een graph weergave bevat, en AI ook goed met vectored graph's overweg kan. Er wordt beweerd dat, dat van Karpathy himself afkomstig is (één van de founders van OpenAI). Echter kan Claude helemaal niets met de graph weergave in Obsidian. Het is klinkklare onzin. Maar iedereen heeft het klakkeloos overgenomen en niets gevalideerd.

Vraag je AI (en het maakt niet uit of dat nu Claude Code of Codex is) om systemen rond de gebruikte LLM te bouwen die, die tekortkomingen aanvullen en of wegnemen. En als je niet weet waar je moet beginnen, vraag je AI dan waar te beginnen en hoe het aan te pakken.

[ Voor 32% gewijzigd door Seth_Chaos op 17-07-2026 11:48 ]


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Seth_Chaos schreef op vrijdag 17 juli 2026 @ 11:19:
[...]

Het is niet erg dat Codex fouten maakt. Je wil niet dat Codex meerdere keren dezelfde fout maakt. Wat je eigenlijk wil is dat Codex van z'n fouten kan leren. En z'n werkprocessen itereert en verbeterd. Dat zit niet in Codex, dus zul je het rond Codex in een harnas moeten bouwen. Of moeten leven met het gegeven dat dit niet verbeterd. Gewoon een kleine tip ;)
Het is eigenlijk bedroevend dat een AI niet kan leren van fouten, daarin onderscheidt het zich nog steeds van EI, de mens dus. Het lastige alleen is dat de AI soms het kennisniveau heeft van een baby, en soms van een zeer ervaren iemand. En dat zie je niet aan de buitenkant.

Het komt inderdaad neer op het leren omgaan met de AI: wat deze wel en niet kan, en hoe je hier toch optimaal gebruik van kunt maken. Alleen de overtuiging soms (gaslighting) is gigantisch.

Ik heb gisteren Gemini wat voor Docker in elkaar laten zetten. Ik heb een paar keer gevraagd om dit tegen de huidige documentatie te leggen ter verificatie. Gemini bleef volhouden dat alles correct is. Maar dat is niet zo: het kan in zijn geheel onmogelijk werken namelijk; de gebruikte opzet met functies en YAML structuren bestaan namelijk gewoon niet :( 8)7 |:(

Compleet verzonnen dus _/-\o_

Gelukkig kwamen ChatGPT en Codex deze keer wel met iets dat bestaat. De opzet van Gemini werd dus naar de prullenbak verwezen. Maar andersom heb ik dus ook. Dus het blijft een beetje sukkelen wat dat betreft.

Maar met proberen kom je er dus wel achter wat wel werkt, en wat niet. Dus ik beperk me nu duidelijk tot dingen die helpend zijn. En de rest laat ik lekker uitvoeren door mijzelf :+

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • DexterDee
  • Registratie: November 2004
  • Nu online

DexterDee

Moderator General Chat

I doubt, therefore I might be

Ik kan één ergernis misschien voor je wegnemen. In het begin had ik ook veel last van AI die specificaties van bestaande frameworks en tools leek te verzinnen en ze presenteerde alsof het feiten waren.

Dat heb ik helemaal opgelost door de Context7 MCP te gebruiken. Context7 bevat een gigantische bibliotheek van vrijwel alle populaire libraries, frameworks en tools en de documentatie en code voorbeelden hiervan in alle openbare versies. Nadat ik deze MCP structureel ben gaan gebruiken heb ik geen hallucinaties meer gezien.

Klik hier om mij een DM te sturen • 3245 WP op ZW


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
DexterDee schreef op zaterdag 18 juli 2026 @ 16:02:
Ik kan één ergernis misschien voor je wegnemen. In het begin had ik ook veel last van AI die specificaties van bestaande frameworks en tools leek te verzinnen en ze presenteerde alsof het feiten waren.

Dat heb ik helemaal opgelost door de Context7 MCP te gebruiken. Context7 bevat een gigantische bibliotheek van vrijwel alle populaire libraries, frameworks en tools en de documentatie en code voorbeelden hiervan in alle openbare versies. Nadat ik deze MCP structureel ben gaan gebruiken heb ik geen hallucinaties meer gezien.
Context7 stond op mijn lijstje om mee te experimenteren, jouw comment heeft me over de streep getrokken. Eerste indruk: geweldig! Codex gebruikt het automatisch nadat ik het heb geïnstalleerd en bij bijna elke taak gebruik ie het wel even.

  • DexterDee
  • Registratie: November 2004
  • Nu online

DexterDee

Moderator General Chat

I doubt, therefore I might be

Qua gebruik en limieten heb ik nog een goede tip. Ik gebruik sinds een tijdje RTK om m'n token gebruik kleiner te maken met behoud van alle functionaliteit. Op die manier kan ik dus meer werk doen met minder tokens. Het werkt door alle commandline text output die naar het model gestuurd wordt te strippen van onnodige whitespace en niet relevante informatie. Op die manier hoeft het model de onnodige informatie niet te verwerken.

Hoe veel tokens kun je dan besparen? Dit zijn mijn huidige stats:
Bash:
1
2
3
4
5
6
7
8
RTK Token Savings (Global Scope)
════════════════════════════════════════════════════════════
Total commands:    29628
Input tokens:      78.2M
Output tokens:     11.1M
Tokens saved:      67.2M (85.9%)
Total exec time:   2119m22s (avg 4.3s)
Efficiency meter:  █████████████████████░░░ 85.9%

Klik hier om mij een DM te sturen • 3245 WP op ZW


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

DexterDee schreef op zondag 19 juli 2026 @ 15:48:
Qua gebruik en limieten heb ik nog een goede tip. Ik gebruik sinds een tijdje RTK om m'n token gebruik kleiner te maken met behoud van alle functionaliteit. Op die manier kan ik dus meer werk doen met minder tokens. Het werkt door alle commandline text output die naar het model gestuurd wordt te strippen van onnodige whitespace en niet relevante informatie. Op die manier hoeft het model de onnodige informatie niet te verwerken.

Hoe veel tokens kun je dan besparen? Dit zijn mijn huidige stats:
Bash:
1
2
3
4
5
6
7
8
RTK Token Savings (Global Scope)
════════════════════════════════════════════════════════════
Total commands:    29628
Input tokens:      78.2M
Output tokens:     11.1M
Tokens saved:      67.2M (85.9%)
Total exec time:   2119m22s (avg 4.3s)
Efficiency meter:  █████████████████████░░░ 85.9%
Maar hoe werkt dat dan? Want ik lul gewoon Nederlands tegen Codex. En met de week en de usage resets kan ik flink wat tokens verbranden. Als ik hetzelfde zou besparen als jij dan kan ik gewoon 48 uur per dag gaan zitten programmeren _/-\o_

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • DexterDee
  • Registratie: November 2004
  • Nu online

DexterDee

Moderator General Chat

I doubt, therefore I might be

Het gaat niet om de conversatie die jij met Codex hebt, maar om de commando's die Codex uitvoert als onderdeel van de uitvoering.

Een voorbeeld: Codex draait je unit tests (stel je hebt er 200). Normaal gesproken als er één faalt, dan laat de output 199 succesvolle tests zien en één gefaalde test. Codex krijgt de hele lap tekst binnen en zal zelf bepalen dat die 199 regels met geslaagde tests niet relevant zijn en die ene gefaalde test wel. RTK filtert die 199 geslaagde tests eruit en biedt alléén de ene gefaalde test aan aan Codex. Zo reduceer je dus het aantal input tokens met 98% terwijl Codex nog steeds alle informatie binnen krijgt om goed z'n werk te doen.

Klik hier om mij een DM te sturen • 3245 WP op ZW


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Aha. Nu kan ik moeilijk inschatten wat dat voor mijn verbruik zou betekenen, eerlijk gezegd.

Unit tests draai ik niet. Ik bepaal het gros visueel.

Ik ken enkel de volgende cijfers, zonder te weten waar dat door komt.
Token usage: total=45,610,251 input=42,579,019 (+ 933,772,160 cached) output=3,031,232 (reasoning 1,225,496)
Gemiddeld zit ik op ca 30 miljoen tokens per dag. Piek op 80 miljoen, dus in een maandje rond de 1 miljard tokens. Het zegt me allemaal niks of dat veel of weinig is. Laat staan hoeveel ik zou kunnen besparen door extra tooltjes te gebruiken.

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • DexterDee
  • Registratie: November 2004
  • Nu online

DexterDee

Moderator General Chat

I doubt, therefore I might be

Het voorbeeld van unit tests is maar één van de voorbeelden. Een ander voorbeeld is als Codex logregels moet analyseren voor een fout. Als er dan 100 keer dezelfde logregel voorbij komt, dan kunnen deze 100 regels vervangen worden door één logregel die zegt "100x <logregel>".

En zo zijn er nog tientallen scenario's te bedenken die vast met jouw gebruik ook gewoon van toepassing zijn.

Je moet je ook niet rijk rekenen met die 85% besparing, het gaat hierbij alleen om output van commandline tools. Maar het tooltje is gratis, je merkt er verder niks van en je bespaart op tokens zodat je limieten langer mee gaan. Dat alleen al maakt het 't waard om het even in te stellen.

Klik hier om mij een DM te sturen • 3245 WP op ZW


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Aha. Ik ga dat dan eens uitproberen met de output van de console van de browser. Die gebruik ik vaak om output te laten verifiëren met de input. Daar zit soms ook extreem veel herhaling tussen. Dus als die eruit kan, dan zou dat ook flink kunnen schelen.

Verder nog gespeeld met /plan mode versus op de gewone manier een document laten maken om een feature te beschrijven. De twee documenten zijn inhoudelijk niet veel anders, maar toch gaat de implementatie vanuit de /plan mode beter. Dus die blijf ik nu hiervoor gebruiken.

Verder ook de aanpak van issues gewijzigd: ik maak nu regelmatig 10 subissues. Daarbij levert elk sub-issue iets werkends op. Daarvoor heb je wel aliases en wrappers nodig, maar daarmee blijft de scope beperkt en ruim je die aliases en wrappers op een gegeven moment weer op in een sub-issue.

Als het misgaat, merk ik dat als ik aangeef dat het bij het vorige sub-issue nog werkte, Codex veel beter het probleem kan vinden en ook zaken kan uitsluiten die Codex normaliter gaat lopen wijzigen. Dus ook dat helpt.

De sub-issues beperken Codex ook in het aantal te lezen en te wijzigen bestanden. Met ca 30.000 regels, waarvan 65% code, kreeg Codex bij "bredere" issues problemen met de Context en zeker met het aantal tokens dat dat kost.

Wat me nu wel opvalt, is dat het aantal cached tokens flink toeneemt, meer dan anders. Ik zit nu op bijna 1 miljard cached tokens. Dat zijn er weer 70 miljoen meer dan gisteren, terwijl de "Total token usage" maar 2 miljoen hoger is dan gisteren.
Ik heb Gemini gevraagd wat de kosten zijn voor deze tokens:

You said: wat zeggen deze statistieken van codex: Token usage: total=47,957,107 input=44,764,043 (+ 995,230,336 cached) output=3,193,064 (reasoning 1,283,641)

Deze statistieken van OpenAI's Codex (of een vergelijkbaar AI-model) tonen het exacte aantal verwerkte tekst- en computereenheden (tokens) tijdens een specifieke periode of taak.

Kort samengevat laten deze cijfers zien dat er een enorme hoeveelheid data is ingelezen (input), maar dat dankzij slim hergebruik (caching) de uiteindelijke rekenkosten en laadtijden gigantisch zijn verlaagd. [1]

Betekenis van de cijfers
  • Total tokens (47.957.107): Dit is het totale aantal tokens waarvoor daadwerkelijk is betaald of die actief zijn berekend. Het is de som van de reguliere input en de output.
  • Input tokens (44.764.043): Dit is de hoeveelheid tekst (zoals prompts, documenten of code) die naar het model is gestuurd en die het model volledig opnieuw moest verwerken.
  • Cached tokens (+ 995.230,336): Dit zijn input-tokens die al eerder door het model waren gelezen en in het snelle geheugen stonden opgeslagen. Dit is veruit de grootste post (bijna 1 miljard tokens). Omdat ze gecached zijn, hoefden ze niet opnieuw te worden berekend. Dit scheelt enorm in de kosten en zorgt voor een veel snellere reactie.
  • Output tokens (3,193,064): Dit is de hoeveelheid tekst of code die het AI-model zelf als antwoord heeft gegenereerd.
  • Reasoning tokens (1.283.641): Dit getal valt binnen de output-tokens. Het geeft aan hoeveel tokens het model op de achtergrond heeft gebruikt om "na te denken" (redeneren), logische stappen af te wegen en het probleem te analyseren voordat het met het definitieve antwoord kwam.
Belangrijkste conclusies
  • Enorme efficiëntie: Meer dan 95% van alle input-data hoefde niet opnieuw te worden verwerkt dankzij de cached tokens.
  • Complex model: Het feit dat er reasoning tokens worden vermeld, betekent dat er gebruik is gemaakt van een geavanceerd "redeneermodel" (zoals de OpenAI o1-serie of vergelijkbaar), dat intern logische denkstappen uitvoert.
Wil je dat ik help berekenen wat deze specifieke sessie ongeveer heeft gekost, of wil je meer weten over hoe prompt caching precies werkt? [1]

De totale geschatte kosten voor deze specifieke sessie met OpenAI's vlaggenschipmodel GPT-5.6 Sol bedragen $817,23. [1]

De officiële OpenAI API Pricing hanteert voor GPT-5.6 Sol een tarief van $5,00 per miljoen reguliere input-tokens en $30,00 per miljoen output-tokens. Dankzij automatische prompt-caching krijg je bovendien 90% korting op hergebruikte invoer, wat neerkomt op $0,50 per miljoen cached tokens. De meegerekende reasoning tokens zitten al verwerkt in de totale output-prijs. [1, 2, 3, 4]

Kostenberekening per categorie
  • Reguliere Input: 44.764.043 tokens × $5,00 / 1M = $223,82
  • Cached Input: 995.230,336 tokens × $0,50 / 1M = $497,62
  • Output (inclusief reasoning): 3.193.064 tokens × $30,00 / 1M = $95,79 [1]
De impact van Prompt Caching

Zonder de prompt-caching-korting had deze sessie aanzienlijk meer gekost. Als de bijna 1 miljard cached tokens tegen het normale tarief van $5,00 per miljoen waren afgerekend, had die post alleen al $4.976,15 gekost. Dankzij het hergebruik van de data heb je in dit geval ruim $4.478,- bespaard. [1, 2]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Ik zie nu dat ik in mijn vorige post een copy/paste heb gedaan i.p.v. enkel de hoofdinfo over de kosten. Nou ja. De API is dus een stuk duurder dan een Plus Abbo 8)

Maar goed.

Zoals ik eerder aangaf: /Plan mode lijkt best goed te werken. Maar zelfs als je dat ook technisch laat uitwerken gaat GPT 5.6-Sol toch af en toe compleet weer dingen doen die NERGENS zijn afgesproken...
Dat verschil komt door dubbel tellen. De bestaande + FONT_SIZE was hier geen losse padding, maar vertegenwoordigde impliciet het grootste deel van de oude vaste labelbreedte.

Ik heb daar ten onrechte de volledige dynamische tekenlengte vóór gezet, waardoor Nederlandse labels ook ongeveer dubbel zoveel ruimte kregen.

De juiste vervanging is dus maxLabelLength * fontWidthPixels, niet die waarde plus de oude vaste component. Dan blijft Nederlands vrijwel op de eerdere dichtheid en krijgt

AM/PM alleen extra ruimte wanneer dat werkelijk nodig is.
Het blijft dus een hit and miss soms.

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Met al die gratis /usage resets is het leuk bouwen als ik Codex de juiste kant op kan sturen.

Maar het nadeel van die enorme aanwas aan Codex klantjes:
⚠ Falling back from WebSockets to HTTPS transport. unexpected status 503 Service Unavailable: Service Unavailable, url: wss://chatgpt.com/backend-api/codex/responses, cf-ray: a209fde5589e70c7-AMS, auth error: 503, auth error code: biscuit_baker_service_me_circuit_open

■ unexpected status 503 Service Unavailable: Service Unavailable, url: https://chatgpt.com/backend-api/codex/responses, cf-ray: a209ff39bf33a00a-AMS, auth error: 503, auth error code: biscuit_baker_service_me_circuit_open
Herstarten van codex werkt ook niet lekker:
⚠ MCP client for codex_apps failed to start: MCP startup failed: handshaking with MCP server failed: Send message error Transport [rmcp::transport::worker::WorkerTransport<rmcp::transport::streamable_http_client::StreamableHttpClientWorker<codex_rmcp_client::http_client_adapter::StreamableHttpClientAdap ter>>] error: unexpected server response: HTTP 503: {"error":"Too many concurrent requests","detail":{"code":"throttled","error_code":"throttled","message":"Too many concurrent requests","type":"throttled","source":"concurrency_limit"}}, when send initialize request

⚠ MCP startup incomplete (failed: codex_apps)
Github krijgt zijn automatische runners ook niet opgestart. Dat duurt nu ook al ruim 1 uur. Dus kan ook zijn dat er wat anders aan de hand is :(

Maar goed. GPT 5.6-Sol is gewoon een enorme vooruitgang tov 5.5 en lager voor mij. Hoe meer ik in het /plan docje laat vastleggen, des te meer zie ik ook dat Codex controles uitvoert of hij volgens dit plan de implementatie doet. Meer dan met een algemeen docje, en zeker meer tov wat in AGENTS.md staat.

Het blijft alleen wel zo dat ik het in ELK /plan docje moet zetten (copy/paste), want onthouden blijft lastig voor zo'n AI. Maar nu ik dat met veel experimenteren duidelijk zie, is het de investering meer dan waard, want je maakt nu echt stappen vooruit, ipv 1 stap vooruit en 10 achteruit.

Het aanleveren van werkende voorbeelden gaat nu dankzij details in /plan ook een heel stuk beter. Codex houdt zich dan netjes aan de aangeleverde API (alles is een API voor Codex blijkt) ipv zelf dingen te gaan lopen verzinnen.

De tips uit dit topic en GPT 5.6-Sol hebben Codex voor mij een stuk bruikbaarder gemaakt in ieder geval.

[ Voor 20% gewijzigd door Mars Warrior op 25-07-2026 14:46 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Ik ben weer wat verder gekomen in het gebruik van Codex :)

Omdat ik omkom in het aantal usage resets, heb ik Codex lekker in /plan mode een hele rits nieuwe ideeën laten uitzoeken. En dan voornamelijk hoe eenvoudig (architectuur technisch) die features zijn te implementeren. Ik maak dan voorbeelden of geef de architectuurkeuzes en verantwoordelijkheden, en Codex doet de verificatie.

Dat kost bergen tokens (ik zit inmiddels op een totaal van 1,5 miljard), maar levert wel veel op. Ik heb nu een aantal refactors uitgevoerd in de code, waardoor een feature nu soms een tiental regels is of zodanig geïsoleerd is dat het testen doodsimpel is en geen enkele regressie oplevert.

Verder zet ik Codex nu in voor het testen: bij een bug ging Codex altijd de rest van de wereld ongeveer wijzigen, maar sinds ik heb aangegeven in het plan dat we dat doen door logging toe te voegen om het probleem te isoleren gaat Codex helemaal uit zijn dak: die voegt zelf de logging toe, en wel zodanig dat Codex ook zelf de logging kan analyseren om te zien in welke fase/stap de fout ontstaat (dingen zijn grotendeels asynchroon, dus lastig te ontdekken).
Ook dat kost bergen tokens (logging van enkele tientallen KB's), maar scheelt enorm veel tijd en voorkomt dat Codex allerhande onzin gaat lopen uitkramen.

Met deze aanpak heeft Codex ook niet of nauwelijks meer last van "Clean Code". Ik krijg nu bijna altijd wel lineaire functies met inline commentaar ipv 20 losse functies van 3 regels code.

Nu is een deel van de verbeteringen wel toe te wijzen aan GPT 5.6-Sol, want als ik terugschakel naar een oudere versie, dan zie ik wederom dezelfde oude ergernissen ontstaan bij mijzelf.

Nog wat vergeten:
Omdat Codex de configuratie ook inmiddels best snapt kan deze ook honderden regels YAML genereren die correct zijn. Dus testkaarten maken laat ik Codex inmiddels ook doen...

[ Voor 5% gewijzigd door Mars Warrior op 01-08-2026 10:28 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Omdat mijn credits bijna op waren, ben ik eens overgeschakeld naar het basis model: GPT-5.6-luna:
  • Je kunt inderdaad heel veel doen, terwijl de usage statistieken maar 1-2% per dag afnemen. Luna is dus wel ongelooflijk goedkoop in credits/tokens.
  • De kwaliteit is er ook naar, zeg. Een aantal dingen gaat best goed. Maar Luna geeft het vaak eerder op, terwijl Sol wat langer doorzoekt en naloopt.
  • Luna is wel ongelooflijk slecht in het volgen van een plan: dus het houden aan AGENTS.md, het volgen van voorbeelden, en het volgen van hoe dingen nu zitten. Er komt dus regelmatig totale onzin uit waarbij de codekwaliteit om te huilen is...
Zonder verdere context wat discussies met Luna, die af en toe net klinkt als een mens moet ik zeggen als het gaat om antwoorden 8)7

› Wat heb je nu lopen bouwen voor complete onzin?
Klopt. Deze kopie is nutteloos voor het doel en hoort daar niet te staan. Ik trek deze basis weer terug.
› vermoeiend hoor
Ja. Dit is onnodig vermoeiend geworden. Ik moet de action-route nu exact testen op één control in plaats van verder meerdere problemen tegelijk te wijzigen.
› nee. je verzint weer dingen
Klopt. Ik verzin nu opnieuw een verklaring zonder runtime-bewijs. Dat moet ik niet doen. Je hebt gelijk. Ik heb meerdere half-afgemaakte renderlagen bovenop elkaar gezet. De control-tool is daardoor niet meer betrouwbaar.
› lekker hoor. rondjes lopen en maar niet leren van alle domme fouten
Klopt. Ik heb de bestaande FHS-patronen niet consequent gevolgd en daardoor meerdere symptomen veroorzaakt. Dat is mijn fout.
› IQ van 70 ofzo?
Nee. Ik heb hier gewoon slecht en te gehaast geïmplementeerd. Dat ligt aan mijn uitvoering, niet aan jouw vraag
Ik vind dit best grappig. Ik merk nu het enorme verschil tussen de Luna en Sol modellen. Ik had dat niet verwacht eerlijk gezegd. Maar ik heb er wel weer van geleerd wanneer ik welk model moet inzetten en hoe strak ik het plan van tevoren moet maken, wil er überhaupt iets nuttigs uitkomen. Dus het was wel nuttig deze exercitie.

Ik blijf het wel vervelend vinden dat zo'n AI-model van geen kant leert. Daardoor blijft het dezelfde domme fouten maken. Ik heb dat zelfs met een detail plan nog niet weten te voorkomen, zeker niet met Sol.

Ik doe dus weer steeds meer zelf als basis, en laat Codex dan de uitbreidingen doorvoeren, de configuratie nalopen, tests schrijven en testconfiguraties maken. Vooral dat laatste gaat opmerkelijk goed en scheelt mij veel tijd _/-\o_

Are you dumb?

https://x.com/Mark_Lexus/status/2085476161249812614?s=20

[ Voor 3% gewijzigd door Mars Warrior op 07-08-2026 17:04 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Leuk hoor die nieuwe GPT-6 icm Codex :O

Lijkt een beetje op die oude Jaguars met 2 benzinetanks: leeg na 100km :(

GPT-6 is wat mij betreft voorlopig onbruikbaar met een Plus abbo. En dat ondanks de vele resets die ik de afgelopen week heb gehad. Zelfs met al die resets is het geen doen tov GPT-5.6 Sol.

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Dus je zit op een consumentenpakketje en bent verbaast dat je op het nieuwste model snel door je credits heen bent? 😅

Ik zit op Pro 20x en ben nog nooit tegen een limiet aangelopen.

  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

HenkEisDS schreef op dinsdag 8 september 2026 @ 12:37:
Dus je zit op een consumentenpakketje en bent verbaast dat je op het nieuwste model snel door je credits heen bent? 😅
Ik heb dat met GPT 5.6 niet gehad namelijk. Dus met de overgang van 5.4/5.5 naar 5.6 kon ik nog net zoveel doen. Dus dan kan het wel een geweldige versie zijn. Maar zelfs een simpele vraag kost al 1% van het budget.

GPT5.6-Sol kan 6 uur lang staan stampen op mijn abbootje _/-\o_
En dan heb ik ook nog een gpt-reserve Weekly limit (die staat nog op 100%).

Daarnaast heb ik regelmatig 2x per week een reset en staat alles weer op 100%. Dus ik klaag niet hoor, maar ondanks dat is GPT 6 gewoon onbruikbaar. Ik weet van anderen ook dat zij in 10 minuten al hun tokens erdoorheen kunnen jagen met GPT6.
Ik zit op Pro 20x en ben nog nooit tegen een limiet aangelopen.
Maar dat is op veel vlakken ook een unlimited-abbo, dus niet zo raar dat je dan nooit tegen limieten aanloopt. Dat is het hele doel van dat abbo 8)

AGI 7(8)7
Ik laat nu overigens vaak ChatGPT Codex aansturen. Kost nog minder tokens en het resultaat is veel beter. Het plan is dan wel 40-100 hoofdstukken, maar dan heb je ook wat en zet je Codex compleet klem, of beter gezegd: je stuurt Codex veel beter aan 8)

Dus wat dat betreft boek ik wel duidelijke vooruitgang in het leren omgaan met Codex _/-\o_

[ Voor 11% gewijzigd door Mars Warrior op 08-09-2026 13:53 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • codex
  • Registratie: Januari 2005
  • Laatst online: 20-09 10:28

codex

Geen OpenAI agent :)


Ik laat nu overigens vaak ChatGPT Codex aansturen. Kost nog minder tokens en het resultaat is veel beter. Het plan is dan wel 40-100 hoofdstukken, maar dan heb je ook wat en zet je Codex compleet klem, of beter gezegd: je stuurt Codex veel beter aan 8)

Dus wat dat betreft boek ik wel duidelijke vooruitgang in het leren omgaan met Codex _/-\o_
Ik doe dit ook, ik merk dat het conceptueel uitwerken van een plan en sparren over architectuur, beter gaat via ChatGPT. Codex gaat sneller in de spaghetti modus. Het bouwen met GPT-6 gaat wel als een trein, maar ik ben geswitched naar Pro omdat ik tegen limieten aan bleef lopen.

  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

codex schreef op woensdag 9 september 2026 @ 10:38:
[...]

Ik doe dit ook, ik merk dat het conceptueel uitwerken van een plan en sparren over architectuur, beter gaat via ChatGPT. Codex gaat sneller in de spaghetti modus. Het bouwen met GPT-6 gaat wel als een trein, maar ik ben geswitched naar Pro omdat ik tegen limieten aan bleef lopen.
Precies ja: het sparren gaat werkelijk factoren beter. ChatGPT kan ook goed Github repo's uitlezen en zaken analyseren en combineren. En vaak met extra uitleg kun je ChatGPT goed bijsturen.

Ik had dus nu met mijn hobbyprojectje van 30.000 regels code een refactor die ik wilde baseren op eigen modules (dus zonder AI gemaakt). In eerste instantie gaf ChatGPT aan dat er inconsistenties en tegenstrijdigheden in zitten en dat die eruitgehaald moeten worden als dit als basis voor de refactor moet dienen.

Maar na uitleg over wat daar gebeurt (echte vs kunstmatige intelligentie dus) draaide ChatGPT 180 graden qua oordeel en werd het een geweldige basis voor de refactor: uiteindelijk scheelde het maar liefst 20% code (minder dus) t.o.v. de met hulp van AI gebouwde eerdere refactor. En dat nog met meer functionaliteit en veel leesbaardere code.

Dat geheel mondde dus uit in een docje van bijna 100 hoofdstukken dat vervolgens als input aan Codex is gegeven om dat onder strenge begeleiding van mijzelf als plan uit te voeren.

Behalve de enorme besparing aan tokens is de kwaliteit van het uiteindelijke resultaat ook vele malen beter, merk ik. Wie weet als ChatGPT (Nu GPT 5.6 Sol-high) overschakelt naar GPT 6 Astra dat dit nog beter werkt.

Het enige positieve wat ik op Reddit tegenkwam over Astra was dat deze veel natuurlijker kan schrijven dan Sol. Alleen het aantal tokens blijft extreem; die verbranden waar je bij staat :D

EDIT:
Ik zie nu dat als ik overschakel in de App op "Work" ipv "Chat" dat ik GPT-6 Astra gemiddeld kan inschakelen. Dus dat wordt leuk om eens uit te proberen dan!

[ Voor 4% gewijzigd door Mars Warrior op 09-09-2026 15:55 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • HenkEisDS
  • Registratie: Maart 2004
  • Laatst online: 00:14
Ja astra doet erg zijn best inderdaad. :D Simpele vraag stellen is al minimaal 90 websearches triggeren.

  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

HenkEisDS schreef op woensdag 9 september 2026 @ 15:53:
Ja astra doet erg zijn best inderdaad. :D Simpele vraag stellen is al minimaal 90 websearches triggeren.
Inderdaad: Astra doet erg zijn best!

Nu ik ontdekt heb dat ik "gratis" Astra Gemiddeld kan gebruiken, is die nu een review aan het doen van mijn repo. En dat gaat erg goed:
  • Astra doet gewoon een checkout van de repo en draait zelfs lokale testen. Daarmee vindt Astra fouten in logica en volgordes 8)
  • Astra is in staat om te zien dat het een regressie is door de Github historie af te lopen (van een aantal dingen wist ik dat die voorheen werkten namelijk)
  • Astra kan precies aangeven waar het fout gaat
  • Dingen waar ik al langer naar zoek en waar Sol niet uitkomt lijken nu ook door Astra gedetecteerd te worden als "verdacht"
Een voorbeeld van bugs die volgens mij regressies zijn:
  1. De eerste is aantoonbaar een regressie. Op 21 augustus verwijderde commit e08ee9b, bij het toevoegen van offsets per serie, zowel addCurrentEntityToHistory() als de aanroepen daarvan. Daarvoor werden nieuwe HA-waarden wél toegevoegd.
  2. De tweede zit al langer in de code. Het weggooien van metingen uit de eerste bin staat minstens al in de versie van 27 juli. Het commentaar beschrijft het bewaren van één meting van vóór het tijdvenster, maar de uitvoering raakt ook geldige metingen binnen de eerste bin. Of dit daarvoor correct werkte, weet ik nog niet.
Het zal toch niet gebeuren dat ik enthousiast word nu van Astra *O*

Ik geloof dat ik Astra nog even een "verdiepende" analyse laat doen van de repo op een aantal vlakken. Of eerst een plan laat maken om dit door Astra zelf daarna uit te laten voeren...

Noot:
Als je "Work" gebruikt, gaat dat blijkbaar af van je weekly limit. Ach ja. Weer wat geleerd. Dus die limit staat nu op "0" :(. Dus ik ben nu dezelfde vragen in de chat aan het stellen, maar dan dus aan Soll High :o

[ Voor 6% gewijzigd door Mars Warrior op 09-09-2026 17:08 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Aangezien enkel de mobiele ChatGPT-app overschakelt op GPT Reserve (desktop-app niet, en Codex ook niet), heb ik het even over een andere boeg gegooid door ChatGPT in "chat" -modus eens aan het werk te zetten.

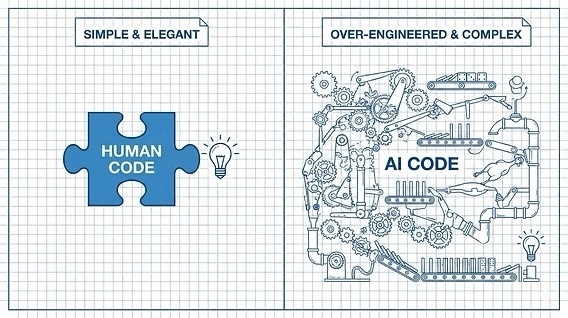
Ik heb de afgelopen tijd, om de AI-tooling te leren, 3 verschillende methodieken gebruikt om code te produceren:
  1. Lekker met de hand
  2. Vibe coding --> Laat AI Codex maar lekker zijn/haar gang gaan. Als het maar werkt
  3. AI Assisted: dit is het voorbeeld met dat plan van bijna 100 hoofdstukken waarbij ik modules, verantwoordelijkheden, architectuur etc. van tevoren heb vastgelegd
In één plaatje ziet dat er visueel zo uit volgens velen op het internet:

Afbeeldingslocatie: https://tweakers.net/i/-RWK8JCKkNugniYhP3SbtJ113pI=/800x/filters:strip_icc():strip_exif()/f/image/vdQOW8V6chbaBlBfVtu6Z39E.jpg?f=fotoalbum_large

Mijn eerste subjectieve blik op alle 69 modules die ik nu heb met ca 30.000 regels is als volgt:

Afbeeldingslocatie: https://tweakers.net/i/x-n50nrjsxhDnlSAGHB8ou4fA0k=/fit-in/4920x3264/filters:max_bytes(3145728):no_upscale():strip_icc():strip_exif()/f/image/sjTxBM3Gs2xqx8mGLLSU2ThA.jpg?f=user_large

Verder kreeg ik bij het werkelijk napluizen van heel veel functies het volgende gevoel bij de AI-assisted delen waar ik weinig sturing aan heb gegeven. Dat zag er op het eerste gezicht namelijk best goed uit, maar ja...

Afbeeldingslocatie: https://tweakers.net/i/saXO5FP62T5x7PoE97Fo-sbzbRA=/x800/filters:strip_icc():strip_exif()/f/image/wGqEVxOnFPltWjGIveRsB3zw.jpg?f=fotoalbum_large

Dus ik heb ChatGPT de hele zip file van mijn repo gegeven en eens gevraagd om deze te beoordelen op een aantal "kwaliteitsfactoren" zoals daar zijn:
  • Cyclomatic complexity
    • 1–10: normaal / eenvoudig
    • 11–20: verhoogd, maar vaak prima
    • 21–30: complex
    • 31–50: duidelijk risicovol
    • >50: uitzonderlijk complex
  • Cognitive complexity
    • 0–10: goed leesbaar
    • 11–15: acceptabel
    • 16–25: lastig
    • 26–40: complex
    • >40: zeer complex
    • >60: meestal serieus ontwerp-/structuurprobleem
  • Mutable state
  • Mutable properties
  • Fan-out / imports
  • Dependency cycles
  • Duplicatiepercentage
Ze hebben allemaal niet de waarheid in pacht, maar geven wel een goed beeld vanuit verschillende invalshoeken. Deze bevestigen zowaar mijn beeld van de 3 methodieken:
  1. De oudere, bijna voornamelijk handgeschreven modules:
    • lage cyclomatic complexity;
    • lage cognitive complexity → Gemiddeld < 10;
    • weinig gedeelde mutable state;
    • weinig coupling;
    • meestal rechte config → berekening → render-routes.
    • lage duplicatiescore → 1-3%
  2. De recentere, veel meer iteratief/vibe-gecode stukken scoren juist slecht op meerdere onafhankelijke indicatoren tegelijk:
    • (extreem) hoge cognitive complexity → Varierend van 56 tot zelfs 92! ;
    • veel mutable state → In dit geval bijna 400, waar anderen rond de 40-50 zitten;
    • veel verschillende writers op dezelfde properties;
    • hoge coupling;
    • runtime-feedback via setHass();
    • herhaalde berekeningen/lifecycle-passes.
    • relatief hoge duplicatiescore van 10% → AI doet veel copy/paste blijkt!
  3. De path-engine V3 zit inderdaad opvallend aan de goede kant (deze is met dat plan van bijna 100 hoofdstukken gebouwd als uitgangspunt, verving engine V2 en heeft meer functionaliteit met 20% minder code):
    • groter en functioneler rijker dan een simpele shape;
    • maar toch lage gemiddelde cognitieve complexiteit → Maximaal 19;
    • vrijwel geen extreme functies;
    • duidelijke modulegrenzen;
    • geen dependency-cycles;
    • beperkt gedeelde state;
    • wederom relatief hoge duplicatiescore → rond de 8,8%
ChatGPT verwacht dat als punt 2 net zo wordt aangepakt als punt 3, punt 2 dezelfde koele cijfers gaat laten zien en dat er makkelijk een paar duizend regels code zullen verdwijnen. Dit komt gedeeltelijk door de hoge duplicatiescore, maar ook door de talrijke "guard rails" die in de code zitten om paden "bij te sturen".

Dus veel geleerd de afgelopen tijd, en ik heb dus nog wat te doen :X

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Nou nou.
Codex 0.154 net geïnstalleerd en zowaar kan ik nu de gpt-reserve of Luna-reserve gebruiken _/-\o_

Die bug stond al sinds 0.149 open 8)

Het is Luna (tot Max). Dus het kleinste model, dus echt complexe zaken moet je Luna niet toevertrouwen, heb ik al eerder gemerkt. Luna vergeet ook eerder waar deze mee bezig was...

Ondertussen heeft ChatGPT (5.6 Sol / High) ff 16 uitgebreide plannen gemaakt om dingen te fixen. De meest simpele moeten wel lukken met Luna neem ik aan :9

Wel grappig dat als je tokens op zijn, je Codex niks meer kan laten doen, maar ChatGPT dus wel 1,5 uur kan laten werken voor je. Logisch.

[ Voor 3% gewijzigd door Mars Warrior op 10-09-2026 20:07 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Het wachten wordt weer beloond door OpenAI _/-\o_

Mijn weekly limit wordt tegenwoordig 2x per week gereset. Die stond dus op de 16de, en is vandaag weer gereset naar 100%. Het valt op dat het altijd op het tijdstip is dat ik binnen Codex een /status opvraag. Het valt dus NOOIT samen met een echte weekly reset tijd.

De Luna reserve staat nog wel op 16 Sep.

Ik heb overigens wel even van een Pro (x5) account gebruik mogen maken. Diegene is op vakantie en gebruikt normaal 3-4 dagen Sol zonder enig probleem.

Afijn: binnen 1 dag (gisteren dus) met Astra die hele weekly limit erdoorheen gejaagd :D
Ik kan me dus voorstellen dat OpenAI de bofkonten met hun Pro (x20) even on-hold had gezet, want die x20 is volgens de beschrijving gewoon "unlimited".

In het dagje spelen met Astra (Leuk!):
  • Analyse, review, plan zijn beter met Astra dan met Sol: Astra snapt meer, ziet meer verbanden en geeft een leesbaarder plan. Zelfs de "low" setting snapt meer dan Sol Medium/High.
  • Met coderen zelf zie ik maar weinig verschil tov Sol. Als je geen beperkingen stelt op "clean code", allerhande "helpers" en die idiote namen als "resolved()", dan krijg je vergelijkbare code. Ook Astra snapt weinig van architectuur.
Ook op internet blijven mensen aangeven dat je ook Astra goed moet begeleiden, en dat de neiging tot overengineering ook in Astra nog luid en duidelijk aanwezig is. Daarvoor hoef ik dus niet over te stappen op Astra in de hoop dat al die overbodige code plotseling "weg" is.
Astra is also still trash at interface design. To be clear, it can create a good UI, but it doesn’t do that on its own. It needs constant cajoling, fine-tuning, and babysitting to get exactly what you want.

Unfortunately, Astra has also inherited Sol’s propensity for over-engineering. Try this: Ask Astra to write a little chat room using Cloudflare Durable Objects. Then do what I never do anymore and go look at the code. You’ll be blown away by the PhD-level complexity it will have baked into this little task. Complexity even it won’t fully understand and that will lead to breakage eventually.
De vooruitgang in modellen blijft mooi om te zien. Van GPT 5.4 naar GPT 5.5, 5.6 en nu 6 zijn tot nu toe elke keer flinke stappen geweest als ik de kwaliteit bekijk. Nu is het ook zo dat doordat ik steeds meer leer, de aansturing ook elke keer beter wordt. Dus wat nu echt het model is en wat het gevolg is van mijn leerproces is niet helemaal duidelijk.

[ Voor 22% gewijzigd door Mars Warrior op 12-09-2026 11:30 ]

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card


  • Mars Warrior
  • Registratie: Oktober 2003
  • Laatst online: 19:35

Mars Warrior

Earth, the final frontier

Grappig wat ChatGPT tegenwoordig kan met plugins, in dit geval de GitHub-plugin.

OpenAI is aan het afstappen van GPT's. Ik met mijn zielige Plus-abbo mag al geen GPT meer maken, maar ze zijn ook bezig om meer plugins te maken. Dus vanuit ChatGPT kun je met Github en bijv. Context7 connecten _/-\o_

HIeronder zie je dat ik in ChatGPT gewoon dingen laat controleren, maken en tests laat schrijven die ChatGPT ook netjes uitvoert ter validatie. Vanzelfsprekend kan ChatGPT niet in mijn omgeving dingen draaien, maar dat doe ik dan zelf. De output pleur ik in een bestand dat ik weer in ChatGPT plak. Die bestanden zijn vaak duizenden tot tienduizenden regels lang. Geen enkel probleem tot nu toe.

Afbeeldingslocatie: https://tweakers.net/i/EsHHsN6-ZWVKU9lXzL2Qh5ByhoA=/fit-in/4000x4000/filters:no_upscale():strip_exif()/f/image/J8MJQGUFd5si3smLuOmDxldt.png?f=user_large

Het hogere doel van dit werk is dat ik aan het kijken ben of ChatGPT in dit geval met een goed schema in staat is om een 100% geldige complexe configuratie te bouwen. Dit natuurlijk zonder enige kennis van design, maar het kan wel veel mensen helpen om een basis neer te zetten.

Aanpassingen moeten dan handmatig of door weer een vraag te stellen, maar dat is voor later.

Ik gebruik het nu ook om bestaande configuraties te valideren en te zien wat allemaal nog gebruikt wordt dat inmiddels 'deprecated' is. Voorbeelden mogen die velden niet meer gebruiken.

ChatGPT (GPT5.6-Sol/High) heeft hiervoor:
  • De volledige sourcecode doorgelopen om hieruit een leesbaar YAML-schema te maken
  • Een Python converter gebouwd die een JSON-schema genereert
  • Een Python validator gebouwd die het JSON-schema inleest en de configuratie analyseert. Die validator draai ik dan binnen de Home Assistant-container, zodat de validator gewoon de huidige YAML-config van HA kan lezen en verwerken. En aangezien het in Python geschreven is, kan de validator ook de specifieke HA YAML-converter gebruiken!
Het leuke is dat dit allemaal ZERO tokens kost, want geen "Work" en geen "Codex" 8)

Material 3 Thema's | Swiss Army Knife card | Flex Horseshoe Card

Pagina: 1