Asus Z390 Maximus IX Hero, Intel 9900K, RTX3080, 64GB DDR4 3000, 2TB NVME, Samsung 850Evo 1TB, 4 x 14TB Toshiba, Be Quiet SB 801, Samsung 34"
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes

Een dikke maand verder en nu eindelijk Qwen3.8 op mijn 5090 geprobeerd. Ditmaal een app in Rust vibe coding (het tonen van jpg-files als slide show). Maar ging niet goed; keer op keer '}' te weinig en de "Reasoning Loop" deficit waarbij deze niet uit een eindeloze loop komt.Vishari Beduk schreef op zondag 23 augustus 2026 @ 10:45:
Ik lees enthousiaste verhalen over Qwen3.8 dus vanochtend zelf de 27B gedownload en opgestart in LM studio. Vervolgens op een andere pc met mijn source code pi opgestart en daarmee verbonden.
En dan eerst even een rant over al die 'testen' op youtube; de meeste geven als input één prompt en dan wordt er een geheel nieuwe app geschreven. Maar dat doe ik bijna helemaal nooit, ik heb bestaande apps die aangepast moeten worden.
Anwyay de eerste test was het aanpassen van C# code, prompt "in ##RequestHandler convert Lambda Expression into Query Expression". Resultaat was code vol fouten die niet eens compileert. Fail.
De tweede test was aanpassen Angular code, prompt "component azure-app-services has a resourceLink column but its content is a very long URL, do you have suggestions to improve visibility?". Resultaat was een nog groter drama; een paar verkeerde regels aangepast en na half uur gaf hij het op. Fail.
Vervolgens precies dezelfde prompt in mijn 20 dollar account aan Claude Sonnet gegeven. Daar was click, click even wachten en prima resultaat.
Dus ik blijf bij mijn eerdere conclusie; die lokale LLM's zijn interessant om mee te experimenteren maar komen niet in de buurt van Claude.
Daarna eens op zoek gegaan om internet over de meningen maar blijkt dat Rust en Qwen3.8 geen goede combinatie is.

Dus ik blijf nog steeds bij mijn eerdere conclusie; die lokale LLM's zijn interessant om mee te experimenteren maar komen niet in de buurt van Claude.
AI: claude / RTX 5060ti / RTX 5090
- DeNachtwacht
- Registratie: December 2005
- Niet online

@Vishari Beduk ik moet je dan toch teleurstellen of juist blij maken: zie deze subreddit: https://www.reddit.com/r/Qwen_AI/comments/1wrk63y/comment/pcpjxar/?context=1&screen_view_count=2
Ik ben zelf at the moment aan het testen en het werkt dus echt. met een single RTX 5090 krijg ik zo'n 80-100 tokens/s afhankelijk van de prompt met 128K context. Maar het draait dus al met een RTX 5070 met 12 GB vram op 40 tokens/s. Hoe hij het gedaan heeft is grote delen van de weights in het ram zetten (je hebt dus ook wel minimaal 64 GB ram nodig) en ook een optimale versie van Flash Next (Q3) te gebruiken en wat andere trucjes. Met 256K context zit ik inclusief mijn 5060 Ti op zo'n 65 tokens/s.
Ik moet zeggen dat het voor mij nog zelfs een beetje magie voelt zulke snelheden met zo'n groot model, maar het werkt. Dus als iemand me uit kan leggen hoe dit in godsnaam kan, graag, maar anders profiteer ik er sowieso van
[ Voor 5% gewijzigd door DeNachtwacht op 29-09-2026 14:20 ]
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Als het zou werken dat ik daadwerkelijjk mijn 5090 zou kunnen gebruiken om 'echte' apps te vibe coden in Rust dan zou ik niet teleurgesteld zijn maar juist heel erg blij.DeNachtwacht schreef op dinsdag 29 september 2026 @ 14:14:
@Vishari Beduk ik moet je dan toch teleurstellen of juist blij maken: zie deze subreddit: https://www.reddit.com/r/Qwen_AI/comments/1wrk63y/comment/pcpjxar/?context=1&screen_view_count=2
Ik ben zelf at the moment aan het testen en het werkt dus echt. met een single RTX 5090 krijg ik zo'n 80-100 tokens/s afhankelijk van de prompt met 128K context. Maar het draait dus al met een RTX 5070 met 12 GB vram op 40 tokens/s. Hoe hij het gedaan heeft is grote delen van de weights in het ram zetten (je hebt dus ook wel minimaal 64 GB ram nodig) en ook een optimale versie van Flash Next (Q3) te gebruiken en wat andere trucjes. Met 256K context zit ik inclusief mijn 5060 Ti op zo'n 65 tokens/s.
Ik moet zeggen dat het voor mij nog zelfs een beetje magie voelt zulke snelheden met zo'n groot model, maar het werkt. Dus als iemand me uit kan leggen hoe dit in godsnaam kan, graag, maar anders profiteer ik er sowieso van
Maar reddit post zegt mij niets. Ik lees over token per sec en een 128k context. Dat is mijn probleem niet, zat tokens per sec. Probleem is dat qwen niet in staat is om problemen in een Rust programma van slechts 160 regels op te lossen.
edit / disclaimer; ik had wel eerst de optimale parameters opgezocht voor temp, context size etc voordat ik qwen startte
[ Voor 4% gewijzigd door Vishari Beduk op 29-09-2026 14:34 ]
AI: claude / RTX 5060ti / RTX 5090
- CT
- Registratie: September 2001
- Laatst online: 19:48
📱💻 🎮 ⌚🖥

Opzich is qwen wel de brainz maar die harness zorgt voor de rest.. ik zou gewoon is een andere agent proberen (pi.dev doet het bijv uitermate goed met qwen), ook dingen als thinking op 'medium' is belangrijk om te voorkomen dat qwen 'overthinked' en dus looped. En uiteraard de quant, alles onder Q6 maakt het model er niet beter op.. liefst minimaal Q8 (en voor de duidelijkheid Qwen 3.8 27b dense). Zelf merk ik weinig verschil met Opus 4.5 of Qwen3.8 voor mijn usecases, grote verschil is over het algemeen naar mijn mening dat op 'het internet' iemand een Ollama oid. start gewoon 'use qwen' indrukt, en slechte resultaten krijgt en het hele babytje met badwater het raam uitgooidVishari Beduk schreef op dinsdag 29 september 2026 @ 14:29:
[...]
Als het zou werken dat ik daadwerkelijjk mijn 5090 zou kunnen gebruiken om 'echte' apps te vibe coden in Rust dan zou ik niet teleurgesteld zijn maar juist heel erg blij.
Maar reddit post zegt mij niets. Ik lees over token per sec en een 128k context. Dat is mijn probleem niet, zat tokens per sec. Probleem is dat qwen niet in staat is om problemen in een Rust programma van slechts 160 regels op te lossen.
edit / disclaimer; ik had wel eerst de optimale parameters opgezocht voor temp, context size etc voordat ik qwen startte
 (En dan hebben ze een A3B model in Q2 getest onder de motorkap.. bij wijs van)
- kazuka
- Registratie: Juli 1999
- Niet online
Building Better Worlds

Heeft iemand hier al de bankrekening geplunderd voor zo'n mooie Mac Studio M5 Ultra met 96GB of zelfs 256 GB RAM? De mogelijkheid om modellen als DeepSeek Flash of GLM 5.3 Flash of Qwen 3.8 Next volledig lokaal te kunnen draaien met goede performance klinkt aantrekkelijk maar het prijskaartje brengt me meteen weer terug op aarde 
Moet zeggen dat sinds Opus 5.5 en nu Sonnet 5.5 ik veel minder hard door mijn tokens ga en ik de frontier modellen combineer met kleinere lokale modellen op mijn RTX5090. Lijkt me voorlopig het meest kostenefficiënt totdat de prijzen weer enigszins normaliseren. De vraag is hoe lang dat nog duurt.
Moet zeggen dat sinds Opus 5.5 en nu Sonnet 5.5 ik veel minder hard door mijn tokens ga en ik de frontier modellen combineer met kleinere lokale modellen op mijn RTX5090. Lijkt me voorlopig het meest kostenefficiënt totdat de prijzen weer enigszins normaliseren. De vraag is hoe lang dat nog duurt.
- DeNachtwacht
- Registratie: December 2005
- Niet online
Even een aanvulling omdat ik het vermoeden heb dat iets niet duidelijk is, die reddit post gaat dus over het draaien van Qwen 3.8 Flash Next. Dat is een 122B MoE model (120GB groot in Q4), totaal onvergelijkbaar met Qwen 3.8 27B. Maar je kan hem dus via die tool al op één RTX 5090 draaien.Vishari Beduk schreef op dinsdag 29 september 2026 @ 14:29:
Maar reddit post zegt mij niets. Ik lees over token per sec en een 128k context. Dat is mijn probleem niet, zat tokens per sec. Probleem is dat qwen niet in staat is om problemen in een Rust programma van slechts 160 regels op te lossen.
edit / disclaimer; ik had wel eerst de optimale parameters opgezocht voor temp, context size etc voordat ik qwen startte
[ Voor 6% gewijzigd door DeNachtwacht op 29-09-2026 17:55 ]
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Ik gebruik sowieso altijd pi.devCT schreef op dinsdag 29 september 2026 @ 14:58:
[...]
Opzich is qwen wel de brainz maar die harness zorgt voor de rest.. ik zou gewoon is een andere agent proberen (pi.dev doet het bijv uitermate goed met qwen), ook dingen als thinking op 'medium' is belangrijk om te voorkomen dat qwen 'overthinked' en dus looped. En uiteraard de quant, alles onder Q6 maakt het model er niet beter op.. liefst minimaal Q8 (en voor de duidelijkheid Qwen 3.8 27b dense). Zelf merk ik weinig verschil met Opus 4.5 of Qwen3.8 voor mijn usecases, grote verschil is over het algemeen naar mijn mening dat op 'het internet' iemand een Ollama oid. start gewoon 'use qwen' indrukt, en slechte resultaten krijgt en het hele babytje met badwater het raam uitgooid
model dat ik gebruikt had is de Q_M_K variant (als ik het goed heb uit mijn hoofd, die pc staat nu uit)
Het ziet er veelbelovend uit, krijg het alleen niet werkend. In de chat prompt zie ik inderdaad wel iets van 40 tokens/s maar alleen op localhost. Echt wel dik een uur bezig geweest met google en de host parameter maar blijft hardnekkig op 127.0.0.1 staan. Ook in de py code alle vaste adressen proberen te wijzigen maar niks.DeNachtwacht schreef op dinsdag 29 september 2026 @ 17:55:
[...]
Even een aanvulling omdat ik het vermoeden heb dat iets niet duidelijk is, die reddit post gaat dus over het draaien van Qwen 3.8 Flash Next. Dat is een 122B MoE model (120GB groot in Q4), totaal onvergelijkbaar met Qwen 3.8 27B. Maar je kan hem dus via die tool al op één RTX 5090 draaien.
Ik wil dus connecten vanaf een linux pc met pi.dev
AI: claude / RTX 5060ti / RTX 5090
- DeNachtwacht
- Registratie: December 2005
- Niet online
@Vishari Beduk hmm, ik heb er op Linux geen ervaring mee. In windows 11 is het echt de "start here.bat" aanklikken, kiezen welk model je wil (de grootste), de aangeraden context voor je GPU (128K) en alles wordt gedownload en geinstalleerd (in een venv). En de host is inderdaad 127.0.0.1, op poort 8080 in je browser heb je dan gewoon een GUI en haal ik 75-80 tokens/s. En ik zit op DDR4-3200, dus dikke kans dat het met een DDR5-6000 systeem nog wat gunstiger uitpakt.
Het is volgens https://github.com/Niko1221/Strata in linux toch gewoon downloaden en setup.sh executen en hetzelfde? Volgens mij kan dat niet snel mis gaan (ook benodigde cuda, python etc wordt in die venv gewoon automatisch geinstalleerd)?
Het is volgens https://github.com/Niko1221/Strata in linux toch gewoon downloaden en setup.sh executen en hetzelfde? Volgens mij kan dat niet snel mis gaan (ook benodigde cuda, python etc wordt in die venv gewoon automatisch geinstalleerd)?
[ Voor 7% gewijzigd door DeNachtwacht op 30-09-2026 10:24 ]
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
@DeNachtwacht Strata is geinstalleerd op een Windows 11 pc naast ComfyUI, Forge Neo en LM Studio en dat werkt ook allemaal. Krijg die monitor/chat/settings pagina's wat ook echt werkt. Probleem is dat Strata alleen op 27.0.0.1 luistert. Maar ik wil vanuit een Linux pc met pi.dev verbinden naar Qwen zodat ik daar in Rust kan programmeren (of eigenlijk; zodat Qwen daar voor mij in Rust kan programmeren).
AI: claude / RTX 5060ti / RTX 5090
- DeNachtwacht
- Registratie: December 2005
- Niet online
@Vishari Beduk Ah... goed om dit te weten want bij mij staat op het weekendprogramma om hem aan mijn OpenClaw te gaan hangen die op een externe Linux pc draait. Ik lees in het info venster dat je die extern moet kunnen benaderen via http://127.0.0.1:8080/v1 (openAI) of http://127.0.0.1:8080 (anthropic)
Ik ben er nu overigens ook mee bezig en goed nieuws... bij grotere promptopdrachten is hij zelfs beduidend sneller. Ik vermoed dat hij bij kleine prompts / opdrachten relatief meer tijd kwijt is om e.e.a. vanuit ram naar vram te verplaatsen en andersom (dat probleem is er normaal natuurlijk niet als alles in vram zit). Maar ik zit door de band genomen toch wel op zo'n 95 tokens/s vanochtend en hoger komt ook voor. Maakt verder voor bruikbaarheid niet uit, maar onderaan natuurlijk wel lekker dat alles dus 20-25% sneller gaat. Maar bovenal vind ik het wel echt indrukwekkend met maar 32GB vram en een model van in totaal 82GB groot.
Ik ben er nu overigens ook mee bezig en goed nieuws... bij grotere promptopdrachten is hij zelfs beduidend sneller. Ik vermoed dat hij bij kleine prompts / opdrachten relatief meer tijd kwijt is om e.e.a. vanuit ram naar vram te verplaatsen en andersom (dat probleem is er normaal natuurlijk niet als alles in vram zit). Maar ik zit door de band genomen toch wel op zo'n 95 tokens/s vanochtend en hoger komt ook voor. Maakt verder voor bruikbaarheid niet uit, maar onderaan natuurlijk wel lekker dat alles dus 20-25% sneller gaat. Maar bovenal vind ik het wel echt indrukwekkend met maar 32GB vram en een model van in totaal 82GB groot.
[ Voor 21% gewijzigd door DeNachtwacht op 30-09-2026 12:50 ]
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Ik bedacht mij dat ik natuurlijk ook een netwerk share kan opzetten en dan zelf de code van het chat window naar files over te zetten. Zodoende ... korte prompt geschreven, code overgezet en gecompileert. Bleek een fout in de code te zitten, tweede prompt om fout te laten herstellen. En weer ging het mis op dezelfde wijze waarop qwen in lm studio ook de mist in ging met een oneindige loop.
Tijdens het wachten op qwen op een andere pc copilot dezelfde opdracht gegeven. En deze kwam met code welke direct goed compileerde en veel beter was. Al moet ik wel zeggen dat claude opus niet meer beschikbaar is via copilot en ik sonnet gebruikte. Kost een paar centen maar dan heb je ook wat.
TL;DR Qwen is het niet voor mij
AI: claude / RTX 5060ti / RTX 5090
- CT
- Registratie: September 2001
- Laatst online: 19:48
📱💻 🎮 ⌚🖥
Heb toevallig vanochtend markdown file vol geschreven met een 'brain fart' van een idee, Qwen aangeslingerd en 10min later "To try it: npm run build && npm run preview → [url="http://localhost:4173"]http://localhost:4173[/url]"
En werkt prima, mooie eerste POC en al mn idee'en zitten er in... mij hoor je niet klagen, hangen en loops heb ik sowieso nog nooit meegemaakt met qwen overigens (ook niet met 3.6).
En werkt prima, mooie eerste POC en al mn idee'en zitten er in... mij hoor je niet klagen, hangen en loops heb ik sowieso nog nooit meegemaakt met qwen overigens (ook niet met 3.6).
- kleneman
- Registratie: Juli 2008
- Laatst online: 13-10 10:44

Ik ben mee aan het lezen, en ga dit weekend eindelijk ook zelf experimenteren. Ik heb voornamelijk interesse in een "lokale Claude Code". Ik probeer zoveel mogelijk te RTFM'en, maar kan me toch niet inhouden alvast wat te vragen: is het realistisch om dit voor elkaar te krijgen op een Macbook?
Ik draai alles op een Macbook Pro met M3 Max en 36GB. Ollama, OpenWeb Ui en Qwen3.8 en Gemma4. Niet supersnel, maar ik heb geduld, en voor chat-achtige dingen prima. (Samenvattingen, vertalen, brainstormen).
Ik doe voornamelijk web en Python. Ik ben van plan in het weekend met Aider te gaan spelen, en heb hoge verwachtingen. Ik lees over wisselende resultaten, maar heb ook een sterk bomen/bos-gevoeld met al het AI nieuws.
- rinkel
- Registratie: September 2002
- Laatst online: 22:07

@kleneman 36GB lijkt me wat klein eerlijk gezegd. Je heb ook nog context nodig.
Ik heb een 32GB shared mem NUC16, maar kleine modellen leveren mij matige code op en context kan ik niet kwijt.
Maar ik ben wel heel benieuwd of een Mac dat beter doet.
Ik heb een 32GB shared mem NUC16, maar kleine modellen leveren mij matige code op en context kan ik niet kwijt.
Maar ik ben wel heel benieuwd of een Mac dat beter doet.

Pak incoai's qwen3.8-27b-splash op de laatste versie van lm studio anders. Die is behoorlijk vlot vanwege speculative decoding en omdat het een 4bit quant is ook redelijk compact.kleneman schreef op donderdag 1 oktober 2026 @ 09:25:
Ik ben mee aan het lezen, en ga dit weekend eindelijk ook zelf experimenteren. Ik heb voornamelijk interesse in een "lokale Claude Code". Ik probeer zoveel mogelijk te RTFM'en, maar kan me toch niet inhouden alvast wat te vragen: is het realistisch om dit voor elkaar te krijgen op een Macbook?
Ik draai alles op een Macbook Pro met M3 Max en 36GB. Ollama, OpenWeb Ui en Qwen3.8 en Gemma4. Niet supersnel, maar ik heb geduld, en voor chat-achtige dingen prima. (Samenvattingen, vertalen, brainstormen).
Ik doe voornamelijk web en Python. Ik ben van plan in het weekend met Aider te gaan spelen, en heb hoge verwachtingen. Ik lees over wisselende resultaten, maar heb ook een sterk bomen/bos-gevoeld met al het AI nieuws.
- kleneman
- Registratie: Juli 2008
- Laatst online: 13-10 10:44
Okee, ik ben nog niet zover dat ik die nuances begrijp, maar daar ga ik induiken. Hopelijk kan ik dan de link van @CT wat beter ontcijferen :-)
Ik zoek overigens echt een command line assistent, niet een IDE of code editor integratie. Dat is LM Studio zo te zien? (Hoewel dat, ongerelateerd, ook weer interessant lijkt om mee te spelen. Zoveel te ontdekken!)
Overigens, ik heb geduld dus prima dat 't model er een paar minuten over doet, en dan met een mooie refactor van mijn functie komt. Ik heb nu met sommige vragen aan Qwen3.8-27b in OpenWebUI dat hij m'n Macbook merkbaar traag maakt. Dan knijp ik hem liever wat af dat 'ie er langer over doet, maar dat ik ondertussen kan doorwerken.
Heb nog nooit met alle parameters en settings wat gedaan, nog eentje om in te duiken dus.
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
"npm run build" --> Jij hebt hebt het dus over JavaScript of TypeScript. Mee eens, youtube staat vol met filmpjes van testers die precies dit met succes doen.CT schreef op donderdag 1 oktober 2026 @ 09:11:
Heb toevallig vanochtend markdown file vol geschreven met een 'brain fart' van een idee, Qwen aangeslingerd en 10min later "To try it: npm run build && npm run preview → [url="http://localhost:4173"]http://localhost:4173[/url]"
En werkt prima, mooie eerste POC en al mn idee'en zitten er in... mij hoor je niet klagen, hangen en loops heb ik sowieso nog nooit meegemaakt met qwen overigens (ook niet met 3.6).
Mij gaat het specifiek om Rust, de taal met extreme eisen aan de code. Met Rust bestaat het probleem dat de LLM in een eindeloze loop terecht komt.
edit: Ik had gister gepost dat Strato niet remote zou werken maar dat probleem is opgelost. De fout die ik maakte was dat ik de host en setup parameter lost van elkaar invoerde.
From your phone or another PC: START-HERE.bat --setup --host 0.0.0.0 --api-key <secret>, then open the address the server window prints
Nu kan ik strata vanuit pi aansturen en dat werkt heel veel beter dan via chat
[ Voor 19% gewijzigd door Vishari Beduk op 01-10-2026 21:16 ]
AI: claude / RTX 5060ti / RTX 5090
- Jorisslagter
- Registratie: Oktober 2026
- Laatst online: 22:53
Maker van Hangar Valley

Ha DeNachtwacht, mooie startpost, ik herken de afwegingen. Ik ben zelf al een tijd bezig met een eigen assistent. Op lokale model(len), en alles eromheen wel in eigen beheer: ze draait in een Linux-container op een Mac Studio thuis, met een eigen brug naar mijn browser, mijn telefoon en de Mac. En voor spraak en andere wat zwaardere dingen ze communiceren met mijn PC (videokaart 5080 16GB). Ze leest mijn mail en agenda, houdt klussen en routines (ik noem ze loops) bij, heeft een eigen geheugen en stuurt via plugins mijn verlichting en tv aan. Het snelle taalmodel komt nog uit de cloud, maar data, geheugen en tools blijven thuis. En voor eenvoudige taken maakt ze gebruik van Ollama, Gemma en/of Qwen.
Wat me opvalt: het model is zelden het probleem. Het lastige is de orkestratie eromheen, wanneer pakt ze zelf iets op, wanneer vraagt ze om toestemming, en hoe houdt ze context vast over langere tijd. Daar zie ik de meeste agents nog struikelen. Ik ben erg benieuwd naar jouw ervaringen, zeker met systemen die wat langer draaien.
Wat me opvalt: het model is zelden het probleem. Het lastige is de orkestratie eromheen, wanneer pakt ze zelf iets op, wanneer vraagt ze om toestemming, en hoe houdt ze context vast over langere tijd. Daar zie ik de meeste agents nog struikelen. Ik ben erg benieuwd naar jouw ervaringen, zeker met systemen die wat langer draaien.
Hangar Valley: rustige vlieggame voor pc, Mac en Quest. Topic hier
- DeNachtwacht
- Registratie: December 2005
- Niet online
@Jorisslagter vergeet @ocf81 niet, hij heeft het allemaal gestart. Ik ben er ook maar tester/hobbyist mee hoor met een openclaw agent. Puur om te leren hoe alles werkt. Ik merk daarbij inderdaad ook dat goed afkaderen heel belangrijk is, wat dat betreft zijn setups via n8n o.i.d. denk ik toch nog superieur voor veel geautomatiseerd werk. Simpelweg omdat je daarmee de grenzen veel sterker kan afkaderen en dan kun je ook nog prima met een Gemma 4 of Qwen 3.5 9B vaak aan de slag zelfs.
Ook voor jou geldt trouwens wel de tip eens te kijken naar dat github linkje dat ik hierboven postte als je 64GB ram hebt. Een 5080 is één van de beste kaarten om via strato Qwen 3.8 Flash Next mee te draaien.
Ook voor jou geldt trouwens wel de tip eens te kijken naar dat github linkje dat ik hierboven postte als je 64GB ram hebt. Een 5080 is één van de beste kaarten om via strato Qwen 3.8 Flash Next mee te draaien.
- Jorisslagter
- Registratie: Oktober 2026
- Laatst online: 22:53
Maker van Hangar Valley
@DeNachtwacht dank, en @ocf81 natuurlijk, die mooie startpost was een goede aftrap. Ik herken je punt: het model is zelden het probleem, het is het afkaderen en de orkestratie eromheen. Daarom houd ik het bewust smal: een eigen container met eigen tools, en voor de zwaardere spraak een pc met een 5080. n8n is voor vaste stromen inderdaad sterker; ik gebruik liever iets dat niet in een vast stramien past. Dat github-linkje ga ik bekijken, dank. Heeft iemand hier trouwens al ervaring met Jev van TypeSafe? Die System One Models klinken interessant voor snelle, gestructureerde beslissingen in plaats van chat.
Hangar Valley: rustige vlieggame voor pc, Mac en Quest. Topic hier

Aangezien ik continue tegen tijd (work) limieten en hoge abonnementsprijzen aan liep bij ChatGTP en Claude zelf maar eens aan de slag gegaan met lokale AI, heb de afgelopen week behoorlijk wat tijd geïnvesteerd en geëxperimenteerd en ben eerlijk gezegd best wel onder de indruk van de prestaties.
Inmiddels op mijn 14" MacBook Pro (2021) M1 Max / 32c GPU / 64GB RAM / 400 GB/s. Een complete lokale AI-omgeving opgebouwd:
Als praktijktest heeft de lokale AI inmiddels zelfstandig een complete website gebouwd, inclusief image generation en een lokale server opgezet binnen 10 minuten, ziet er wat mij betreft echt netjes uit en is uiteraard alleen maar bedoeld als experiment.
Ben benieuwd of ik nog iets mis qua aanvulling, suggesties?
Inmiddels op mijn 14" MacBook Pro (2021) M1 Max / 32c GPU / 64GB RAM / 400 GB/s. Een complete lokale AI-omgeving opgebouwd:
- Ollama + Open WebUI
- Qwen 3.6 35B MLX als hoofdmodel op 32K context (~50–56 tok/s)
- Qwen Embedding 4B + RAG met ~125 eigen ChatGPT-chats geïmporteerd
- Open Terminal/tools voor bestanden en Terminal-acties
- ComfyUI voor lokale image generation (eerder Draw Things/SDXL)
- Tailscale voor toegang buitenshuis vanaf de iPhone
- Watchdog + automatische backup/restore naar de NAS.
- ChatGPT-sync: maandelijks handmatig een ChatGPT-export downloaden; daarna worden alleen nieuwe/gewijzigde chats aan mijn lokale RAG/kennisbank toegevoegd.
Als praktijktest heeft de lokale AI inmiddels zelfstandig een complete website gebouwd, inclusief image generation en een lokale server opgezet binnen 10 minuten, ziet er wat mij betreft echt netjes uit en is uiteraard alleen maar bedoeld als experiment.
Ben benieuwd of ik nog iets mis qua aanvulling, suggesties?

- Beekforel
- Registratie: November 2001
- Laatst online: 23:46
Is eigenlijk geen vis

@Greatsword wat is een M1 Max?
- DeNachtwacht
- Registratie: December 2005
- Niet online
@Greatsword indrukwekkend, maar hoe heb je alles laten bouwen dan? Dit klinkt als een openclaw workflow maar dat noem je niet. Of heb je dit anders opgelost? Ik mis dus ff het knoopje tussen alle taken
MacBook Pro met M1 Max
Alles eigenlijk grotendeels met hulp van ChatGPT en Terminal gebouwd.DeNachtwacht schreef op vrijdag 2 oktober 2026 @ 16:09:
@Greatsword indrukwekkend, maar hoe heb je alles laten bouwen dan? Dit klinkt als een openclaw workflow maar dat noem je niet. Of heb je dit anders opgelost? Ik mis dus ff het knoopje tussen alle taken
Heel veel input geven, vragen gesteld, continue screenshots aanleveren voor de juiste instellingen en configuratie en voor de rest copy/paste. Ben zelf geen ontwikkelaar of iets dus fijn dat het me op deze manier toch gelukt is.
- Beekforel
- Registratie: November 2001
- Laatst online: 23:46
Is eigenlijk geen vis
Ok nice dat is best betaalbaar zag ik. Veelbelovend resultaat vind ik.
Ja 2,5 jaar geleden in de aanbieding gekocht voor ~2200,- laatst te koop gezet om te kijken wat ik er nog voor krijgen en had meerdere geïnteresseerde voor 1700,- Uiteindelijk toch maar niet verkocht want een M5 Max met dezelfde specs (64GB / 2TB SSD) ging al snel richting de 6K en dat had ik er niet voor over en blijkbaar is mijn configuratie nog capabel genoeg dus noodzaak is er ook niet voor een upgrade 😉Beekforel schreef op vrijdag 2 oktober 2026 @ 17:24:
[...]
Ok nice dat is best betaalbaar zag ik. Veelbelovend resultaat vind ik.
- Yarisken
- Registratie: Augustus 2010
- Laatst online: 23:27
Wat is daar zo indrukwekkend aan ? Da's wat containers opstarten en aan elkaar lijmen.DeNachtwacht schreef op vrijdag 2 oktober 2026 @ 16:09:
@Greatsword indrukwekkend, maar hoe heb je alles laten bouwen dan? Dit klinkt als een openclaw workflow maar dat noem je niet. Of heb je dit anders opgelost? Ik mis dus ff het knoopje tussen alle taken
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Toch wat verder geexperimenteerd met Qwen-Strata-Pi maar helaas.
In het begin lijkt het heel positief; je ziet in Pi dat er grondig onderzoek wordt gedaan wat er mogelijk is en wat er geinstalleerd is op de pc. Best leuk om te zien wat Pi samen met Qwen allemaal doet. Maar na ruim 2 uur dan toch weer in een eindeloze loop. Dat was met Rust.
Toen toch eens iets simpers geprobeert in C# maar dat liep nog sneller vast in een eindeloze loop. En dat terwijl het begin heel hoopvol is, je ziet hier ook weer in het begin Pi/Qwen met goede dingen komen.
De Strata monitor is wel heel mooi.
Daarna toch eens copilot opgestart en deze levert direct in één keer een werkend programma.
edit: Inmiddels een heel andere toepassing gevonden (wat wel werkt)
Je kan in ComfyUI custom_nodes downloaden maar die krijgen dan wel heel veel rechten op je systeem. Je kan dan Pi/Qwen vragen om de code te controleren op kwetsbaarheden. Die doen dan een grondige controle en geven ook aan wat je in de code nog kan verbeteren.
En je kan dan ook de session-jsonl file bewaren en dan later nog eens rustig doorlezen met een JSONL viewer. Super dit
[ Voor 25% gewijzigd door Vishari Beduk op 03-10-2026 09:19 ]
AI: claude / RTX 5060ti / RTX 5090
- zx9r_mario
- Registratie: Oktober 2004
- Laatst online: 22:57

Is dat soms Qwen 3.6 35B-A3B Moe LLM? Dat is een van de beste voor mij.Greatsword schreef op vrijdag 2 oktober 2026 @ 15:41:
Ook flink wat modellen vergeleken: Qwen 3.8 27B, GPT-OSS 20B, Qwen 3.5 122B, Gemma 4 31B en DeepSeek. Uiteindelijk bleek Qwen 3.6 35B voor mij de beste combinatie van snelheid, kwaliteit en RAM-gebruik.
[Afbeelding]
Ja voor mij ook, exacte model is volgens mij qwen3.6:35b-mlx omdat ik op een Mac werk.zx9r_mario schreef op zaterdag 3 oktober 2026 @ 13:08:
[...]
Is dat soms Qwen 3.6 35B-A3B Moe LLM? Dat is een van de beste voor mij.
- R3m3d7
- Registratie: Juli 2007
- Laatst online: 18-10 12:07

Welke quant gebruik je?Vishari Beduk schreef op vrijdag 2 oktober 2026 @ 23:01:
Toch wat verder geexperimenteerd met Qwen-Strata-Pi maar helaas.
In het begin lijkt het heel positief; je ziet in Pi dat er grondig onderzoek wordt gedaan wat er mogelijk is en wat er geinstalleerd is op de pc. Best leuk om te zien wat Pi samen met Qwen allemaal doet. Maar na ruim 2 uur dan toch weer in een eindeloze loop. Dat was met Rust.
Toen toch eens iets simpers geprobeert in C# maar dat liep nog sneller vast in een eindeloze loop. En dat terwijl het begin heel hoopvol is, je ziet hier ook weer in het begin Pi/Qwen met goede dingen komen.
De Strata monitor is wel heel mooi.
Daarna toch eens copilot opgestart en deze levert direct in één keer een werkend programma.
edit: Inmiddels een heel andere toepassing gevonden (wat wel werkt)
Je kan in ComfyUI custom_nodes downloaden maar die krijgen dan wel heel veel rechten op je systeem. Je kan dan Pi/Qwen vragen om de code te controleren op kwetsbaarheden. Die doen dan een grondige controle en geven ook aan wat je in de code nog kan verbeteren.
En je kan dan ook de session-jsonl file bewaren en dan later nog eens rustig doorlezen met een JSONL viewer. Super dit
- zx9r_mario
- Registratie: Oktober 2004
- Laatst online: 22:57
MiMo 2.6 9b is een interessante LLM om te proberen. Met een simpele prompt een complete website getoverd.



[ Voor 73% gewijzigd door zx9r_mario op 03-10-2026 20:24 ]
- Felicia
- Registratie: Maart 2001
- Laatst online: 20-10 12:46

Het kan aan mij liggen maar kan niet ieder 9b model dit zo'n beetje? Zeker omdat deze gebaseerd is op Qwen 3.5 9b?zx9r_mario schreef op zaterdag 3 oktober 2026 @ 20:16:
MiMo 2.6 9b is een interessante LLM om te proberen. Met een simpele prompt een complete website getoverd.
Waar ik me mee bezig heb gehouden is Kokoro met TTS om te kijken of ik ebooks kan omzetten naar audiobestanden. Daarvoor deze repo (Kokoro local gui) maar die kan natuurlijk niet overweg met mijn GPU (want, geen CUDA).
Die dus laten aanpassen zodat de XPU pytorch wordt gebruikt en het werkt nog ook
 Eens kijken hoe lang die er over doet om een relatief korte ebook om te zetten.

Ik draag een rok, wat is jouw excuus?
- zx9r_mario
- Registratie: Oktober 2004
- Laatst online: 22:57
Klopt, maar deze is net wat beter is mijn ervaring.Felicia schreef op zaterdag 3 oktober 2026 @ 20:47:
[...]
Het kan aan mij liggen maar kan niet ieder 9b model dit zo'n beetje? Zeker omdat deze gebaseerd is op Qwen 3.5 9b?
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Er is weinig keus binnen Strata; tijdens setup kan je kiezen tussen chat of coding (waarbij ik coding koos). Vervolgens krijg je wel meer keuzes maar Strata geeft dan zelf al advies op basis van je hardware dus weinig zinvol om daar vanaf te wijken. En als laatste start Strata het model zelf op voor het bepalen van optimale parameters.
Op disk staan dan twee files van Qwen3.8-Flash-Next-GSQ-RCO-IQ1_M
AI: claude / RTX 5060ti / RTX 5090
- R3m3d7
- Registratie: Juli 2007
- Laatst online: 18-10 12:07
Vreemd, ik zie IQ1 niet op de strata github pagina staan.Vishari Beduk schreef op zondag 4 oktober 2026 @ 09:52:
[...]
Er is weinig keus binnen Strata; tijdens setup kan je kiezen tussen chat of coding (waarbij ik coding koos). Vervolgens krijg je wel meer keuzes maar Strata geeft dan zelf al advies op basis van je hardware dus weinig zinvol om daar vanaf te wijken. En als laatste start Strata het model zelf op voor het bepalen van optimale parameters.
Op disk staan dan twee files van Qwen3.8-Flash-Next-GSQ-RCO-IQ1_M
Maar dat deze is https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF snap ik wel dat dit geen goede output geeft, zeker op meer algemene vragen.
Het is leuk dat je een bepaalde quant kan draaien met strata maar strata maakt een Q1 quant niet beter, het maakt hem alleen sneller.
Deze quant zou op basis van de RCO werkwijze de experts voor programmeren op niveau moeten houden maar ik lees daar goede maar ook slechte verhalen over.
- DeNachtwacht
- Registratie: December 2005
- Niet online
@R3m3d7 het voordeel van Strata is vooral dat je er Qwen 3.8 Flash Next ipv Qwen 27B mee kan draaien op consumentenhardware . Dát is het kwaliteitsvoordeel.
- R3m3d7
- Registratie: Juli 2007
- Laatst online: 18-10 12:07
Nou, naar mijn mening is een kleiner model met hogere quant beter dan een groot model op een zeer lage quant. Ik zou liever Q4 27B draaien dan een Q2 Flash next, zeker als je hem ook voor algemeen gebruik wilt inzetten (meer dan programmeren).DeNachtwacht schreef op zondag 4 oktober 2026 @ 11:10:
@R3m3d7 het voordeel van Strata is vooral dat je er Qwen 3.8 Flash Next ipv Qwen 27B mee kan draaien op consumentenhardware . Dát is het kwaliteitsvoordeel.
- ocf81
- Registratie: April 2000
- Niet online

@Jorisslagter Als je ideeën hebt voor de OP, dan ben ik/zijn wij altijd bereid om daar naar te luisteren. Dat kan hier of via een DM. Als je wil meeschrijven, dan kan dat ook. Dat gaat tot nu toe als een soort van zelfverbeterende cyclus waar @DeNachtwacht elkaars werk bekijken en dan daar weer aan toevoegen, wat volgens mij wel aardig werkt. Overigens geldt deze oproep voor iedereen die graag mee wil werken aan de OP
[ Voor 10% gewijzigd door ocf81 op 04-10-2026 11:40 ]
© ocf81 1981-infinity
Live the dream! | Politiek Incorrecte Klootzak uitgerust met The Drive to Survive
Bestrijd de plaag die woke heet! | Servitisatie is slavernij. Kies je eigen weg!
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Ik wil LLM uitsluitend en alleen voor codering gebruiken. Dus zoek gewoon 'whatever' werkt.R3m3d7 schreef op zondag 4 oktober 2026 @ 11:19:
[...]
Nou, naar mijn mening is een kleiner model met hogere quant beter dan een groot model op een zeer lage quant. Ik zou liever Q4 27B draaien dan een Q2 Flash next, zeker als je hem ook voor algemeen gebruik wilt inzetten (meer dan programmeren).
Zojuist met dit model een bestaande app laten aanpassen; de buttons verplaatsen van de onderkant naar de zijkant. Heeft er dik een half uur over gedaan maar het werkt.
Dus voor kleinere aanpassingen is het wel bruikbaar. Ga nu eens kijken hoe het werkt met code completions in vs code.
Maar begrijp mij niet verkeerd; ik klaag niet, ik vind het allemaal prachtig dit. Ben echter wel van mening dat momenteel een Claude abbonement beter en goedkoper is dan duizenden euros uit te geven aan hardware.
AI: claude / RTX 5060ti / RTX 5090
- DeNachtwacht
- Registratie: December 2005
- Niet online
Dat kan, maar die keuze speelt in dit geval simpelweg niet. De kracht van Strata is dat je op een 12GB GPU al Qwen Flash Next 122B kan draaien in Q2. Qwen 3.8 27B is op een 12GB GPU níet te draaien op Q2 (ja, het past nét, maar met zo ongeveer 8K context). Het is dus niet "een groter model in lagere quant draaien of een kleiner model met hogere quant" maar simpelweg: je kan het grootste model al draaien met 12GB vram terwijl het kleine model niet (bruikbaar) draait.R3m3d7 schreef op zondag 4 oktober 2026 @ 11:19:
[...]
Nou, naar mijn mening is een kleiner model met hogere quant beter dan een groot model op een zeer lage quant. Ik zou liever Q4 27B draaien dan een Q2 Flash next, zeker als je hem ook voor algemeen gebruik wilt inzetten (meer dan programmeren).
En dat gaat zo door; heb je 16GB vram, dan kun je Q3 122B draaien, terwijl je op 16 GB Q4 27B niet kan draaien (daar is minimaal 24gb voor nodig). En met 24 of 32GB vram draai je ook Q3 122B, maar flink sneller dan Q4 van 27B, en met meer context. En Q3 122B is op elke taak béter dan Q4 27B.
Kortom je vergelijking gaat niet op. Qwen 2.8 122B draait met Strata in alle gevallen gewoon beter dan Qwen 3.8 27B.
- R3m3d7
- Registratie: Juli 2007
- Laatst online: 18-10 12:07
Fair enough!DeNachtwacht schreef op zondag 4 oktober 2026 @ 13:37:
[...]
Kortom je vergelijking gaat niet op. Qwen 2.8 122B draait met Strata in alle gevallen gewoon beter dan Qwen 3.8 27B.
Ik zou alleen wel willen waarschuwen dat het kunnen draaien van (een versie) van het model niet betekend dat je het model draait zoals je er over leest in de benchmarks en vergelijkingen en dat in de basis een 1:1 vergelijking tussen een kleiner model zonder quatizing het beter zal doen dan een heel groot mode dat kapot is gequantized naar dezelfde omvang als het kleinere model...het is echt een soort lobotomie die ze uitvoeren. Naar mijn ervaring is een MOE model extra gevoelig voor quatizing als he gaat om verlies in qualiteit.
Maar uiteindelijk gaat het om de ervaring van de gebruiker, if it works it works.
- GarBaGe
- Registratie: December 1999
- Laatst online: 19:01

Ik heb Ollama draaien op een RTX3090 met 24GB.
Ik gebruik bij voorkeur Qwen 3.8 27B.
Ik heb nu KV cache kwantisatie aangezet (q8_0) en 2 aangepaste Modelfiles gemaakt met 64k en 128k context.
De 64k context variant gebruikt 20.8GB VRAM en de 128k context variant gebruikt 22.0GB VRAM.
Ik gebruik een CPU met integrated graphics, waar mijn beeldscherm op is aangesloten, dus Windows (en browsers) gebruiken geen kostbare VRAM.
Nu ff testen of 128k een beetje lekker werkt voor programmeren.
Ik had voorheen Claude Code draaien om te connecten naar mijn lokale model, maar ik ga overstappen op Open Code.
Ryzen9 5900X; 16GB DDR4-3200 ; RTX-4080S ; 7TB SSD
- pling
- Registratie: Maart 2001
- Laatst online: 17-10 19:10
Lekker Kepjoeteren

Dit doet me denken aan iets. Ik had ook veel opstart mogelijkheden, verschillende modellen, weinig context, veel, no thinking parallel, etc... het werd een beetje onoverzichtelijk voor me. Ik heb een tooltje laten maken door Qwen waarin ik opstartprofielen kan onderhouden. Platform: Windows + MAUI. Moet je wel van houdenGarBaGe schreef op maandag 5 oktober 2026 @ 10:13:
Ik heb nu KV cache kwantisatie aangezet (q8_0) en 2 aangepaste Modelfiles gemaakt met 64k en 128k context.
. Iemand anders had ook al iets dergelijks gemaakt, maar dat had dan weer te veel functies naar mijn smaak. Zelf gebruik ik dit nu altijd om llama.cpp op te starten.crwsolutions/llama-cpp-starter: App to start llama-cpp-server
- Shinji
- Registratie: Februari 2002
- Laatst online: 01:02

Iemand al de nieuwe Framework Desktop met AI Max+ 495 besteld? Vanaf €7700 ongeveer
- ocf81
- Registratie: April 2000
- Niet online
Tja, momenteel heb ik er het geld even niet voor. Als ik het geld had zou er misschien een aantal in een serverrek gooien om die dan te combineren met een agent o.i.d. Ik heb nu wel een leuke server, waar ik destijds ook wel het geld voor overhad, maar achteraf is het toch wel een beetje dure aanschaf geweest. (mede omdat Stedin nu telkens de benodigde opwaardering van de stroomaansluiting uitsteltShinji schreef op maandag 5 oktober 2026 @ 15:30:
Iemand al de nieuwe Framework Desktop met AI Max+ 495 besteld? Vanaf €7700 ongeveer
 Dat is eigenlijk de meest zure kant van het verhaal)
Wat wel mooi is, is dat de nieuwe Strix Halo nu met een PCI-e sleuf met open einde komt, waardoor er nu wél een fatsoenlijke netwerkkaart in kan worden gedaan. Deze kan dan helaas nog steeds niet op een fatsoenlijke snelheid werken door het gebrek aan PCI-e banen. Het liefst zou ik toch een mogelijkheid voor een 100+ GbE verbinding hebben, maar dat blijft helaas toekomstmuziek. Een sleuf met acht banen zou al heel veel meer mogelijkheden bieden op dat gebied.
Ik ben overigens wel blij dat ik de vier Radeon AI Pro 9700's in mijn KI-server voor ca. €1430 per stuk op de kop heb getikt. Vandaag zou ik daar ca €1800 per stuk voor moeten neerleggen. En als je naar de RTX 5090 kijkt dan zie je dat de prijs daarvan helemaal door het dak is gegaan. Die kostte eerst zo'n €2500 en nu gaat ie niet voor minder dan 6k over de toonbank. In vergelijking met de 5090 is de RTX6000 Blackwell eigenlijk een koopje. Voor 18k, zo ongeveer drie keer het geld, krijg je vier keer de hoeveelheid geheugen. Al met al lijkt deze prijsontwikkeling mij toch te wijzen naar een aardige vlucht van lokale KI. Waarom zou je anders dat soort geld neerleggen voor zo'n kaart? De vraag is wel hoe welke hardware we dan in de toekomst gaan gebruiken voor lokale KI, want de koeling van de chips wordt steeds veeleisender en daarmee wordt het steeds aanlokkelijker om over te gaan op andere verschijningsvormen.
© ocf81 1981-infinity
Live the dream! | Politiek Incorrecte Klootzak uitgerust met The Drive to Survive
Bestrijd de plaag die woke heet! | Servitisatie is slavernij. Kies je eigen weg!
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Voor de grap jouw repo gecloned om te kijken of Qwen dit ook op mijn pc aan de praat krijgt. En dat lukte. Daarna gevraagd om de SQL code te optimaliseren en toen vond het een bugpling schreef op maandag 5 oktober 2026 @ 15:29:
[...]
Dit doet me denken aan iets. Ik had ook veel opstart mogelijkheden, verschillende modellen, weinig context, veel, no thinking parallel, etc... het werd een beetje onoverzichtelijk voor me. Ik heb een tooltje laten maken door Qwen waarin ik opstartprofielen kan onderhouden. Platform: Windows + MAUI. Moet je wel van houden
crwsolutions/llama-cpp-starter: App to start llama-cpp-server
### 1. Real bug: RuntimeRepository.UpsertAsync returned Id = 0 on the conflict path
```sql
SELECT COALESCE(last_insert_rowid(), (SELECT Id FROM Runtimes WHERE ExecutablePath = @ExecutablePath));
```
last_insert_rowid() is 0, not NULL, when the ON CONFLICT … DO UPDATE branch ran (and Microsoft.Data.Sqlite starts a fresh sqlite session per ExecuteAsync, so there is no
earlier insert to leak through). COALESCE only catches NULL ? the fallback never fired. Verified empirically: old form ? 0, fixed form ? existing Id.
```sql
-- last_insert_rowid() is 0 (not NULL) when the DO UPDATE branch ran,
-- so NULLIF is needed before COALESCE can fall back to the lookup.
SELECT COALESCE(NULLIF(last_insert_rowid(), 0), (SELECT Id FROM Runtimes WHERE ExecutablePath = @ExecutablePath));
```
Latent today (RuntimeScannerService ignores the returned Id and re-reads GetAllAsync), but the API contract was wrong.
AI: claude / RTX 5060ti / RTX 5090
- Felicia
- Registratie: Maart 2001
- Laatst online: 20-10 12:46
Ik zat even te kijken of ik die van mij ook al eens gedeeld had maar kennelijk niet, simpele web-GUI die mijn models directory als laadbare modellen pakt. MTP wordt automatisch aangezet indien in de bestandsnaam en llama.cpp parameters als properties in een server config file. Werkt dikke primapling schreef op maandag 5 oktober 2026 @ 15:29:
[...]
Dit doet me denken aan iets. Ik had ook veel opstart mogelijkheden, verschillende modellen, weinig context, veel, no thinking parallel, etc... het werd een beetje onoverzichtelijk voor me. Ik heb een tooltje laten maken door Qwen waarin ik opstartprofielen kan onderhouden. Platform: Windows + MAUI. Moet je wel van houden
crwsolutions/llama-cpp-starter: App to start llama-cpp-server

Ik draag een rok, wat is jouw excuus?
- vargo
- Registratie: Januari 2001
- Laatst online: 20-10 09:18
Dank voor het delen!
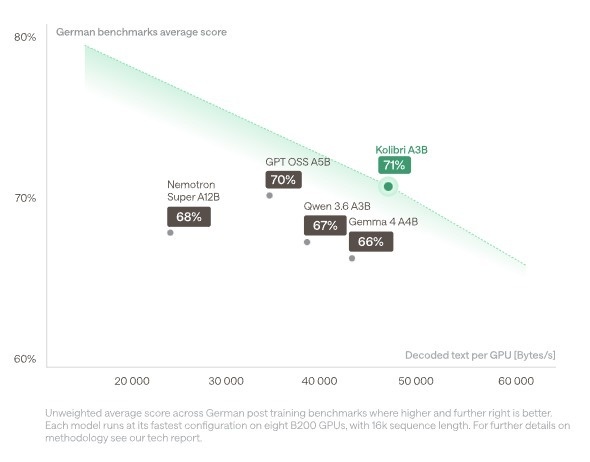
Ziet er best aardig uit - wat kenmerken:
- Model memory footprint: ~78 GB (FP8 weights)
- MoE
- reasoning, tool calling support
- 1M context (al raden ze zelf 256K aan)
- optimized voor engels en duits
- Apache 2.0 licentie

De paper ziet er best leesbaar uit, dus die zet ik op mijn reading list.
Op bladzijde 109 ook nog een summary voor wie geinteresseerd is.
Hoe lang zou het duren voor er een quantizised versie verschijnt?
En vooral heel belangrijk: een Europees model
 - is dit nu het leading model in Europa? (ik meen dat er nu een Spaans model aan kop ging)
- DeNachtwacht
- Registratie: December 2005
- Niet online
Oeh dank voor het delen, het is nog niet vergelijkbaar met de Chinese topmodellen, maar wel mooi dat er toch weer iets nieuws op lijkt te staan in Europa. Hopelijk zetten ze snel een stap verder, Mistral lijkt helaas bijvoorbeeld af te zakken, de radiostilte daar sinds ministral in januari duurt me helaas langzamerhand iets te lang…
- prutser001
- Registratie: Oktober 2004
- Laatst online: 09-10 03:39
Vaak zit het tegen en soms zi

Maar waar draai je dat dan op als je het lokaal zou willen houden? Ik gebruik nu Unsloth om van alles te proberen dat binnen mijn beperkte VRAM (8GB) valt.vargo schreef op dinsdag 6 oktober 2026 @ 12:56:
[...]
Dank voor het delen!
Ziet er best aardig uit - wat kenmerken:Uit de paper:
- Model memory footprint: ~78 GB (FP8 weights)
- MoE
- reasoning, tool calling support
- 1M context (al raden ze zelf 256K aan)
- optimized voor engels en duits
- Apache 2.0 licentie
[Afbeelding]
De paper ziet er best leesbaar uit, dus die zet ik op mijn reading list.
Op bladzijde 109 ook nog een summary voor wie geinteresseerd is.
Hoe lang zou het duren voor er een quantizised versie verschijnt?
En vooral heel belangrijk: een Europees model
Asus Z390 Maximus IX Hero, Intel 9900K, RTX3080, 64GB DDR4 3000, 2TB NVME, Samsung 850Evo 1TB, 4 x 14TB Toshiba, Be Quiet SB 801, Samsung 34"
- vargo
- Registratie: Januari 2001
- Laatst online: 20-10 09:18
8GB zal erg krap zijn, en zal zeker ook afhangen van de rest van je systeem.prutser001 schreef op dinsdag 6 oktober 2026 @ 15:12:
[...]
Maar waar draai je dat dan op als je het lokaal zou willen houden? Ik gebruik nu Unsloth om van alles te proberen dat binnen mijn beperkte VRAM (8GB) valt.
Ik las dat het draait op vLLM (model runtime) met een plugin van de makers van dit model.
De huidige officiele system eisen zijn nogal... fors:
Dwz 160GB aan VRAM, iets wat de meeste thuisgebruikers niet hebben.Model memory footprint: ~78 GB (FP8 weights). Minimum: 2× A100 80 GB, 2× H100 SXM5, 1× H200, 1× B200 or 1× B300. Recommended: 2× H100 SXM5, 2× H200, 1× B200 or 1× B300.
Er zal dus iemand aan de slag moeten om het model geschikt te maken voor mindere hardware.
Hier zijn een aantal technieken voor:
- lagere precisie (de zgn "quant"), waardoor de gewichten in modellen een lagere floating point precisie krijgen. Dit is een vorm van "lossy compression". Je verliest dus informatie en dus kwaliteit. Dit model zit op 8FP, en de vraag is hoeveel je kan comprimeren zonder al teveel kwaliteit in te leveren
- MoE = mixture of experts -> eigenlijk bestaat het model uit aantal sub modellen, waarvan er slechts enkele tegelijk actief zijn (die wil je in het VRAM) hebben. Je kan de rest in RAM of zelfs op disk laten (wel trager, maar dat merk je pas als er geswapt moet worden)
- "pruning" - delen van het model gewoon wissen die minder relevant zijn
[ Voor 7% gewijzigd door vargo op 06-10-2026 16:03 ]
- vargo
- Registratie: Januari 2001
- Laatst online: 20-10 09:18
Vers van de pers!DeNachtwacht schreef op dinsdag 6 oktober 2026 @ 13:37:
Oeh dank voor het delen, het is nog niet vergelijkbaar met de Chinese topmodellen, maar wel mooi dat er toch weer iets nieuws op lijkt te staan in Europa. Hopelijk zetten ze snel een stap verder, Mistral lijkt helaas bijvoorbeeld af te zakken, de radiostilte daar sinds ministral in januari duurt me helaas langzamerhand iets te lang…
PARIS, Oct 6 (Reuters) - French AI company Mistral on Tuesday announced a new AI model, which the company said outperforms some Chinese open-weight models.
Nu ook op mistral zelf: https://mistral.ai/news/mistral-large-4/
[ Voor 7% gewijzigd door vargo op 06-10-2026 16:38 ]
- DeNachtwacht
- Registratie: December 2005
- Niet online
Haha, helaas gaat dat om Mistral 4 Large, wat geen openweight model voor de consument gaat zijn (tenzij je thuis een stuk of 5 RTX 6000 Pro's hebt liggen bij toeval natuurlijk ). Maar wel goed en leuk om te zien dat ze in ieder geval toch door zijn gegaan met eigen modellen. Het GLM model waarmee ze bezig zijn liet me wat twijfelen
). Maar wel goed en leuk om te zien dat ze in ieder geval toch door zijn gegaan met eigen modellen. Het GLM model waarmee ze bezig zijn liet me wat twijfelen
[ Voor 30% gewijzigd door DeNachtwacht op 06-10-2026 16:45 ]
- vargo
- Registratie: Januari 2001
- Laatst online: 20-10 09:18
Jawel; ik las dat volgende maand het model wordt gepubliceerd.DeNachtwacht schreef op dinsdag 6 oktober 2026 @ 16:44:
Haha, helaas gaat dat om Mistral 4 Large, wat geen openweight model voor de consument gaat zijn (tenzij je thuis een stuk of 5 RTX 6000 Pro's hebt liggen bij toeval natuurlijk
(edit: ik las iets te snel dat het geen "open weight" zou zijn; maar we moeten idd afwachten of dit thuis te deployen gaat zijn)
Best aardige benchmarks, mn cybersecurity en agentic work springt eruit. Coding ook prima.Mistral Large 4
Open-weight hybrid instruct-and-reasoning MoE with multimodal input; unifies instruction, reasoning, and agentic capabilities in a single model, state-of-the-art among open weights on cybersecurity, finance, and manufacturing, natively fluent in 160+ languages.
[ Voor 7% gewijzigd door vargo op 06-10-2026 16:50 ]
- pling
- Registratie: Maart 2001
- Laatst online: 17-10 19:10
Lekker Kepjoeteren
Qwen heeft het aangepast:Vishari Beduk schreef op maandag 5 oktober 2026 @ 20:23:
[...]
Voor de grap jouw repo gecloned om te kijken of Qwen dit ook op mijn pc aan de praat krijgt. En dat lukte. Daarna gevraagd om de SQL code te optimaliseren en toen vond het een bug
RuntimeRepository: return existing Id on upsert conflict · crwsolutions/llama-cpp-starter@fc7ccbf
- Felicia
- Registratie: Maart 2001
- Laatst online: 20-10 12:46
Met die constraint zou je ook eens naar de nieuwe FrogNano van Microsoft kunnen kijken (wat een upgrade is op Qwen 3.5 4B): https://huggingface.co/microsoft/FrogNano-4B-2609prutser001 schreef op dinsdag 6 oktober 2026 @ 15:12:
[...]
Maar waar draai je dat dan op als je het lokaal zou willen houden? Ik gebruik nu Unsloth om van alles te proberen dat binnen mijn beperkte VRAM (8GB) valt.
Ik draag een rok, wat is jouw excuus?
- zx9r_mario
- Registratie: Oktober 2004
- Laatst online: 22:57
Met Frog-nano even een Tetris game gemaakt. Met een simpele prompt "create a tetris game in html" in 1 keer werkende game. Best knap voor een 4b model.
- zx9r_mario
- Registratie: Oktober 2004
- Laatst online: 22:57
Nieuwe LLM van JetBrains: Mellum2.1 Thinking is a Mixture-of-Experts reasoning model (64 experts, 8 activated per token, 131,072-token context)
- GarBaGe
- Registratie: December 1999
- Laatst online: 19:01
Ik heb nu Qwen 3.8 27B met 256k context op mijn RTX3090 draaien (net iets meer dan 22GB in gebruik).
Toch zijn de resultaten bij meer Agentic AI werk (programmeren, OpenCode) wat aan de magere kant. Ik denk dat ie veel last heeft van cirkel redeneren en niet goed tot antwoorden komen. Hierdoor kan ie uren bezig zijn en dingen opnieuw oppakken, die hij eerder al heeft gedaan.
Voor test, probeer ik een bestaand Open Source project geschreven in C++ door AI om te schrijven in werkende Rust code (https://github.com/Parchive/par2cmdline)
Gewoon, als vinger oefening.
Ideaal scenario: 1 prompt, een paar uur wachten en klaar. Dat is nog niet gelukt.
Gezien mijn AI machine 96GB systeem RAM heeft, overweeg ik een groter model, bijvoorbeeld 70B, dan draaien in systeem RAM in de vorm van batch-mode (bijvoorbeeld in de nacht) om te kijken of dit beter werkt.
Indien ja, dan ben ik evt bereid een 2e 3090 toe te voegen voor meer VRAM.
Simpelere taken draaien wel prima op de enkelvoudige 24GB RTX3090.
Beetje prompt engineering (OpenWeb UI) of Immich AI module of ComfyUI of nVidia Broadcast video processing.
Een 2e hands datacenter product (zoals een 80GB A100 of H100) ligt vermoedelijk buiten mijn budget.
Al met al, ben ik niet ontevreden. Het is fijn om te zien wat mijn huidige setup wel kan en waar ie moeite mee heeft.
Ryzen9 5900X; 16GB DDR4-3200 ; RTX-4080S ; 7TB SSD
- DeNachtwacht
- Registratie: December 2005
- Niet online
@GarBaGe ik zou dus in jouw geval eens proberen hoe ver je komt met Qwen 3.8 Flash Next Coder in Strata. Moet toch wel 60-70 tokens opleveren en ik denk betere kwaliteit (hoewel het wel MoE is, en de kwantisatie wel echt een rol speelt).
- Exirion
- Registratie: Februari 2000
- Laatst online: 03:42
Gadgetfetisjist

.
[ Voor 200% gewijzigd door Exirion op 13-10-2026 18:43 ]
"Logica brengt je van A naar B, verbeelding brengt je overal." - Albert Einstein
- Exirion
- Registratie: Februari 2000
- Laatst online: 03:42
Gadgetfetisjist
Dat kun je absoluut niet zo generaliseren. Sommige modellen verdragen quantisatie erg goed en DeepSeek V4 experts zijn bijvoorbeeld native getraind op 4-bit. Daarnaast wordt quantisatie ook beter, want er zijn hybride quantisatiemethoden waarbij bijvoorbeeld attention layers zo veel mogelijk intact worden gehouden terwijl de experts zich goed laten quantizen. Met geoptimaliseerde quantisatie kunnen modellen op 4-bit of 3-bit met minimale verliezen performen. DeepSeek V4 Flash (0731) doet het prima op 2.4bit. Qwen 3.8 Flash Next idem op 4-bit.R3m3d7 schreef op zondag 4 oktober 2026 @ 11:19:
Nou, naar mijn mening is een kleiner model met hogere quant beter dan een groot model op een zeer lage quant.
Beide zijn beduidend beter dan Qwen 3.8 27b. Die laatste is vooral zo populair omdat ie in het geheugen van populaire snelle GPU's past. Voor de grootte van het model is het indrukwekkend wat het kan, maar ik geef toch echt de voorkeur aan de andere genoemde modellen. Die draaien in grofweg 100GB geheugen. Met DeepSeek V4.1 en GLM 5.3 heb je weer een stuk meer nodig.
Bij Qwen 3.8 Flash Next zit overigens een aanzienlijke engram die vanaf SSD gelezen kan worden. Er zijn ook engines geoptimaliseerd voor bepaalde modellen te vinden, waarvan de meeste inmiddels expert streaming ondersteunen. LLMs draaiend met beperkt geheugen worden inmiddels steeds bruikbaarder
"Logica brengt je van A naar B, verbeelding brengt je overal." - Albert Einstein
kleine kennis vraag update:
kan je momenteel met huidige local ai modellen het volgende doen met max ee 16gb videokaart.
Of moet je hiervoor echt een claude code of codex gebruiken en dan api account en via vs code etc een link leggen? Die kan dan wel een hele proejct folder uit lezen en op werken?
kan je momenteel met huidige local ai modellen het volgende doen met max ee 16gb videokaart.
- tegen local a.i. zeggen, bouw een arduino ,c#, html combi architectuur dat je het een project folder geeft en zegt maak maar C++ code voor op de hw, C# voor een gui en een html5 website welke data toont van verbinding met het device met bijvoorbeeld een IIS server .
Werkt dit al robuust en kan local ai zon hele source project folder aanvullen en indexeren?
Of moet je hiervoor echt een claude code of codex gebruiken en dan api account en via vs code etc een link leggen? Die kan dan wel een hele proejct folder uit lezen en op werken?
- CT
- Registratie: September 2001
- Laatst online: 19:48
📱💻 🎮 ⌚🖥
@R.G kan wel, maar met 16gb kom je alleen niet ver.. daarmee kan je dit wel vergeten
Ik kwam ook LocalAI tegen onlangs en heb dat is geprobeert, maar dat is toch wel een aardig compleet pakket, mooie is met name dat echt bijna alle modellen (ook voor TTS STT Video Image etc.) direct gefilterd op de hardware die localAI kan vinden. Zo heb ik heel wat nieuwe modellen kunnen ontdekken, de backends die bij een model horen configureert ie dan ook voor je automatisch. Wel de moeite waard is te proberen als je door de bomen het bos niet meer ziet van wat er allemaal beschikbaar is (lokaal).
Ik kwam ook LocalAI tegen onlangs en heb dat is geprobeert, maar dat is toch wel een aardig compleet pakket, mooie is met name dat echt bijna alle modellen (ook voor TTS STT Video Image etc.) direct gefilterd op de hardware die localAI kan vinden. Zo heb ik heel wat nieuwe modellen kunnen ontdekken, de backends die bij een model horen configureert ie dan ook voor je automatisch. Wel de moeite waard is te proberen als je door de bomen het bos niet meer ziet van wat er allemaal beschikbaar is (lokaal).
[ Voor 75% gewijzigd door CT op 14-10-2026 07:17 ]
- vargo
- Registratie: Januari 2001
- Laatst online: 20-10 09:18
Cool idee: dit staat ook bij mij op mijn todo lijstje - ben benieuwd hoe dit gaat.GarBaGe schreef op dinsdag 13 oktober 2026 @ 12:34:
Ik heb nu Qwen 3.8 27B met 256k context op mijn RTX3090 draaien (net iets meer dan 22GB in gebruik).
Toch zijn de resultaten bij meer Agentic AI werk (programmeren, OpenCode) wat aan de magere kant. Ik denk dat ie veel last heeft van cirkel redeneren en niet goed tot antwoorden komen. Hierdoor kan ie uren bezig zijn en dingen opnieuw oppakken, die hij eerder al heeft gedaan.
Voor test, probeer ik een bestaand Open Source project geschreven in C++ door AI om te schrijven in werkende Rust code (https://github.com/Parchive/par2cmdline)
Gewoon, als vinger oefening.
Ideaal scenario: 1 prompt, een paar uur wachten en klaar. Dat is nog niet gelukt.
Gezien mijn AI machine 96GB systeem RAM heeft, overweeg ik een groter model, bijvoorbeeld 70B, dan draaien in systeem RAM in de vorm van batch-mode (bijvoorbeeld in de nacht) om te kijken of dit beter werkt.
Indien ja, dan ben ik evt bereid een 2e 3090 toe te voegen voor meer VRAM.
Simpelere taken draaien wel prima op de enkelvoudige 24GB RTX3090.
Beetje prompt engineering (OpenWeb UI) of Immich AI module of ComfyUI of nVidia Broadcast video processing.
Een 2e hands datacenter product (zoals een 80GB A100 of H100) ligt vermoedelijk buiten mijn budget.
Al met al, ben ik niet ontevreden. Het is fijn om te zien wat mijn huidige setup wel kan en waar ie moeite mee heeft.
Dat cirkel redeneren ken ik: het thinking level speelt een belangrijke rol, en ook een duidelijke instructie van de taak en wanneer het werk voldaan is (DoD) helpt.
Wat ik zou doen is:
- een code migration strategie uitwerken op het hoogste thinking level: een keer door Qwen 3.8 27b en Qwen3.8-flash-next. Oa aangeven dat je een TDD red-green(*) migratie / refactoring gaat doen. De beste strategie wint (of doe een merge van de beste ideen)
- vervolgens een planning laten uitwerken (zou ik ook weer op hoogste thinking level doen, met het model dat de beste strategie heeft
- voor zover de strategie en planning dit niet al aangeven: de oude codebase dit nog niet heeft: een automated regression test set laten schrijven (in C++), en deze laten vertalen naar rust. Je kan natuurlijk aan unit tests denken, maar bv ook features vastleggen in Gherkin (past meer in de Behavioral Driven Development hoek)
- en ik zie deze beschrijving van je app: "par2cmdline is a PAR 2.0 compatible file verification and repair tool." -> dan kan je perfect een aantal PAR2.0 testcases selecteren waarvan je de uitkomst weet (verification true/false, file na reparatie) en die als regressie tests opvoeren
- met een agentic framework de migratie doen, waarbij de rust test cases 100% bevroren zijn -> ik gebruik binnen Pi een aangepast versie van tdd-enforcer, waarbij mijn orchestration agent(**) de rechten heeft om de red/green fase te switchen. Mocht iemand dit interessant vinden let me know (gooi ik het op github).
offtopic:
(*) red-green TDD wil zeggen dat je eerst in test cases het verwachte gedrag vastlegt in de tests. Al je tests zullen nog falen (red status). Vervolgens ga je de code implementeren en zullen alle tests naar 'green' moeten gaan.
(**) mijn agents zijn work-planner, orchestration, coder, test-automation-engineer, dev-sec-ops-engineer, plus nog een aantal andere gespecialiseerde rollen zoals architect, designer, frontend-ender etc etc)
- vargo
- Registratie: Januari 2001
- Laatst online: 20-10 09:18
Ik kwam eigenlijk om te melden dat er op basis van Ninfer nu ook een fork is met support voor Qwen3.8-flash-next: Infernix. Naar verluidt sneller dan Strate, Freetoken in decode, TTFT en prefill.
Decode throughput (tok/s, all N requests together)
N Infernix (MTP) FreeToken* Short TG 1 128.4 105.4 2 167.9 137.7 4 204.6 192.0 Long TG 1 143.6 95.1 2 186.1 115.6 4 NaN** 141.6 Time to first token (one request)
Prompt Infernix (MTP) FreeToken* 28 tokens 179 ms 254 ms 278 tokens 667 ms 649 ms 1,021 tokens 1,529 ms 870 ms Next chat turn (~1,115 tokens, ~90 new) 147 ms 456 ms Fresh ~2.6K tokens 1,556 ms 1,256 ms Fresh ~4.6K tokens 1,587 ms 1,201 ms Fresh ~9.8K tokens 1,692 ms 1,505 ms Prefill of long fresh prompts (tok/s)
Prompt Infernix (MTP) FreeToken* 14K tokens 6,800 6,700 41K tokens 9,000 6,800 124K tokens 9,200 6,700 206K tokens 8,300 6,400
- Salvatron
- Registratie: April 2003
- Niet online
Dispereert niet

Wat kun je ermee? Ik vind die website vaag over wat het precies is, is het net zoiets als lmstudio (of jan.ai)?CT schreef op woensdag 14 oktober 2026 @ 07:12:
Ik kwam ook LocalAI tegen onlangs en heb dat is geprobeert, maar dat is toch wel een aardig compleet pakket, mooie is met name dat echt bijna alle modellen (ook voor TTS STT Video Image etc.) direct gefilterd op de hardware die localAI kan vinden. Zo heb ik heel wat nieuwe modellen kunnen ontdekken, de backends die bij een model horen configureert ie dan ook voor je automatisch. Wel de moeite waard is te proberen als je door de bomen het bos niet meer ziet van wat er allemaal beschikbaar is (lokaal).
het gaat niet goed met de wereld
- DeNachtwacht
- Registratie: December 2005
- Niet online
De valkuil is sowieso dat het internet wordt overspoeld door gevibecode tools om je AI mee te runnen, MCP servers, add-ins et etera. Het biedt maar zelden echt een meerwaarde en het gevaar met die tools is dat het vaak niet eens op 1 ontwikkelaar hangt, maar op 1 vibecoder: dus misschien zelfs iemand die niet eens goed weet wat hij doet en/of snel weer stopt. Dus kans op support/continuiteit is vrij laag.
Als het puur over runners gaat is het ook weer niet zo onoverzichtelijk: llama.cpp, jan, vllm, ollama (als je het gebruiksvriendelijk out of the box wil hebben), unsloth (als je ook wil finetunen). Dat zijn wel de grote tools, en daar is dan nu als enige echt positief uitpakkende gevibecode tool Strata bijgekomen.
Als het puur over runners gaat is het ook weer niet zo onoverzichtelijk: llama.cpp, jan, vllm, ollama (als je het gebruiksvriendelijk out of the box wil hebben), unsloth (als je ook wil finetunen). Dat zijn wel de grote tools, en daar is dan nu als enige echt positief uitpakkende gevibecode tool Strata bijgekomen.
[ Voor 23% gewijzigd door DeNachtwacht op 14-10-2026 11:00 ]
- CT
- Registratie: September 2001
- Laatst online: 19:48
📱💻 🎮 ⌚🖥
@Salvatron het is een beetje llama-swap maar dan met meer (UI) hands-on mogelijkheden, zoals lmstudio e.d. die dan automatisch model en backend voor je installeert lokaal. Je kan dan de build-in chat interface, audio etc. gebruiken ook zit er functies om pipelines te bouwen of 'agent' taken die dan met triggers of cron kunnen werken, of je maakt de openai-api na met verschillende backend componenten, en gebruikt die API in je andere apps etc.etc.
met name hielp het mij met audio (tts en stt) heb zo audiocpp "ontdekt" en deze met de nodige modellen kunnen testen voor wat ik nodig heb, ook voor image-gen (sd-cli en sd-server) heeft het mij mee geholpen, gebruikte afgelopen tijd voornamelijk llm's (llamacpp) maar die doet geen image/audio.
met name hielp het mij met audio (tts en stt) heb zo audiocpp "ontdekt" en deze met de nodige modellen kunnen testen voor wat ik nodig heb, ook voor image-gen (sd-cli en sd-server) heeft het mij mee geholpen, gebruikte afgelopen tijd voornamelijk llm's (llamacpp) maar die doet geen image/audio.
[ Voor 24% gewijzigd door CT op 14-10-2026 11:01 ]
- DeNachtwacht
- Registratie: December 2005
- Niet online
@CT Unsloth probeert dat momenteel ook, een all-in-one oplossing voor tekst, afbeeldingen, audio, video. Punt is een beetje wat ik hiermee heb is dat de vraag maar is of dat wel zo handig is. ComfyUI is de standaard voor afbeeldingen, video, 3D, audio en simpelweg alle andere output dan tekst. Het voordeel is dat deze tool helemaal gespecialiseerd is in control toevoegen via een zelf te bouwen nodebased structuur. En die control wil je juist met al dat soort output.
Dus mijn gevoel is toch dat het niet zo praktisch is omdat die geavanceerde control mist in de all-in-one oplossingen. Ik denk dat het toch het meest praktisch is het op te splitsen in reguliere taalmodellen en de diffusion modellen, puur omdat dit dus ook 2 verschillende soorten AI modellen zijn.
Dus mijn gevoel is toch dat het niet zo praktisch is omdat die geavanceerde control mist in de all-in-one oplossingen. Ik denk dat het toch het meest praktisch is het op te splitsen in reguliere taalmodellen en de diffusion modellen, puur omdat dit dus ook 2 verschillende soorten AI modellen zijn.
- CT
- Registratie: September 2001
- Laatst online: 19:48
📱💻 🎮 ⌚🖥
dat is dus ook waarom 'lokaal' ai zo enorm.. vernevelt is.. de een wil alleen chatten, de ander wilt een agent die hyper specialised je homeassistant kan navigeren, ander puur code agent weer iemand wilt hele image control met flows..DeNachtwacht schreef op woensdag 14 oktober 2026 @ 11:05:
@CT Unsloth probeert dat momenteel ook, een all-in-one oplossing voor tekst, afbeeldingen, audio, video. Punt is een beetje wat ik hiermee heb is dat de vraag maar is of dat wel zo handig is. ComfyUI is de standaard voor afbeeldingen, video, 3D, audio en simpelweg alle andere output dan tekst. Het voordeel is dat deze tool helemaal gespecialiseerd is in control toevoegen via een zelf te bouwen nodebased structuur. En die control wil je juist met al dat soort output.
Dus mijn gevoel is toch dat het niet zo praktisch is omdat die geavanceerde control mist in de all-in-one oplossingen. Ik denk dat het toch het meest praktisch is het op te splitsen in reguliere taalmodellen en de diffusion modellen, puur omdat dit dus ook 2 verschillende soorten AI modellen zijn.
zelf zit ik in code-agent en openai-api (zo compleet mogelijk = transcription, image, chat endpoints), dus code-agent gebruik ik ook de open-api compatible layer, maar llama-swap om het model naar qwen3.8 27b (q8) te laden (grote context, kost je bijna 40gb vram) en als ik general tasks wil gebruiken switch ik nu naar een kleiner qwen-A3b + sb-server + audiocpp om kokoro/qwen image erbij te laden, dat geeft alle endpoints dezelfde mogelijkheden als openai aanbied
comfy-ui heb ik wel is gebruikt, maar toen was er echt een bepaalde art-work workflow nodig om meerdere plaatjes exact hetzelfde te krijgen, dit kost ook echt rendertijd, qwen-image-2.1-turbo bijv maakt in paar seconden een prima plaatje op basis van je input, hele andere usecase dus
nog te zwijgen over audio-chatten (lijkt simpel in chatgpt app maar vereist lokaal een hele pipeline aan stt+transcript+llm+tts pipeline) of document-searches (rerankers, vector databases etc.) dit zit natuurlijk allemaal achter dat simpele chat-venster van chatgpt, maar dat zelf lokaal krijgen is wel een kunstje
Pfoei. Vanavond mijn Qwen3.6-35b-a3b op llama.cpp vervangen door 3.8-flash-next op strata... Dat is bijna even snel en de kwaliteit tot nu toe helemaal niet ontevreden over.
Had alles achter litellm hangen dus kon alle agents Enzo simpel omzetten, werkte perfect
Had alles achter litellm hangen dus kon alle agents Enzo simpel omzetten, werkte perfect
- Vishari Beduk
- Registratie: Februari 2009
- Laatst online: 16-10 08:43
loves f/1.8 primes
Wat ik dan interessant vind is, je leest https://github.com/Wallawalla47/Infernixvargo schreef op woensdag 14 oktober 2026 @ 09:33:
Ik kwam eigenlijk om te melden dat er op basis van Ninfer nu ook een fork is met support voor Qwen3.8-flash-next: Infernix. Naar verluidt sneller dan Strate, Freetoken in decode, TTFT en prefill.
[...]
en dan staat er onderaan "Infernix is developed with Claude Code."
Waarmee hij aangeeft dat Qwen3.8-Flash-Next dus eigenlijk niet zo goed is in coding, en dat is juist wat ik wil.
AI: claude / RTX 5060ti / RTX 5090
- Tweakert1990
- Registratie: April 2026
- Laatst online: 17-10 20:43
@Vishari Beduk ik wil je dan toch graag teleurstellen (of blij maken, weet niet hoe je het interpreteert ) ik ben thuis sinds eergister positief verrast met de combo Visual Studio Code, Strata en Qwen FN Q3-x-s bezig. Ben als test een pixelart game in de vrije uurtjes aan het ontwikkelen die (hopelijk ) wat verder gaat dan die Tweak Battle game van de frontpage van gister. Natuurlijk heeft het zijn limieten, GTA6 moet je niet willen bouwen, maar laten we eerlijk zijn Claude code heb bij zo’n game ook niet genoeg aan. Ook lokaal er is ook veel wél mogelijk met goede prompt engineering en de truc is daarnaar te kijken.
Enige “hulp” hierbij is ook wat game textures die (ook lokaal, in comfyUI) gegenereerd zijn. Dus letterlijk de gehele game is dus met lokale AI gemaakt.
Ik hoop hem over 1-2 weken op GitHub te kunnen zetten (wel even mooi afmaken), zal hem hier wel even plaatsen ook t.z.t.
) ik ben thuis sinds eergister positief verrast met de combo Visual Studio Code, Strata en Qwen FN Q3-x-s bezig. Ben als test een pixelart game in de vrije uurtjes aan het ontwikkelen die (hopelijk ) wat verder gaat dan die Tweak Battle game van de frontpage van gister. Natuurlijk heeft het zijn limieten, GTA6 moet je niet willen bouwen, maar laten we eerlijk zijn Claude code heb bij zo’n game ook niet genoeg aan. Ook lokaal er is ook veel wél mogelijk met goede prompt engineering en de truc is daarnaar te kijken.Enige “hulp” hierbij is ook wat game textures die (ook lokaal, in comfyUI) gegenereerd zijn. Dus letterlijk de gehele game is dus met lokale AI gemaakt.
Ik hoop hem over 1-2 weken op GitHub te kunnen zetten (wel even mooi afmaken), zal hem hier wel even plaatsen ook t.z.t.
[ Voor 22% gewijzigd door Tweakert1990 op 16-10-2026 07:44 ]
Ja, Strata met Qwen3.8-flash-next is nog wel ff een stapje verder dan de 27b dense, dat is wel duidelijk!
- Puff_Uncle
- Registratie: Februari 2020
- Laatst online: 20-10 14:38
welke quant draaien jullie? ff kijken of het op mijn dev pc met 32gb vram en 64gb ramZsub schreef op vrijdag 16 oktober 2026 @ 09:11:
Ja, Strata met Qwen3.8-flash-next is nog wel ff een stapje verder dan de 27b dense, dat is wel duidelijk!
- GarBaGe
- Registratie: December 1999
- Laatst online: 19:01
Bedankt voor je tip over Strata.DeNachtwacht schreef op dinsdag 13 oktober 2026 @ 12:41:
@GarBaGe ik zou dus in jouw geval eens proberen hoe ver je komt met Qwen 3.8 Flash Next Coder in Strata. Moet toch wel 60-70 tokens opleveren en ik denk betere kwaliteit (hoewel het wel MoE is, en de kwantisatie wel echt een rol speelt).
Ik probeer nu de standaard / recommended versie van de standaard setup.
Ik gebruik IQ3_XXS met grofweg 100 tokens/sec en een context van 128k.
23.5GB VRAM (van de 24) en 64GB systeemgeheugen. Best flink.
Strata zelf voelt een beetje experimenteel en niet-af.
Het is een git checkout waar je een script opstart. Dat is heel wat anders dan een Ollama installatie met een icon in je systemtray.
De browser met de monitor dashboard vind ik heel fancy. Zoiets miste ik bij Ollama.
Alhoewel, de "power" grafiek laat alleen de GPU power ziet.
Gezien Strata ook de 20 P-cores van mijn CPU aan het werk zet, kan je er al snel 200-250W aan toevoegen
Ik heb nog niet zo heel veel uren erin zitten, maar hij voelt al wel beter dan Ollama Qwen 3.8 27B. En ondanks het systeem geheugen gebruik, voelt de snelheid alsof deze puur in VRAM loopt.
Als ik er iets meer tijd in heb zitten, wil ik ook de andere modellen proberen, zoals de IQ3_S of de Coder
Ryzen9 5900X; 16GB DDR4-3200 ; RTX-4080S ; 7TB SSD
Ik draai nu één van de Q2s, kan ff niet zien welke. Mijn PC heeft 16GB vram en 50 sysram (naja, 64, maar 14 daarvan is voor een VM die m'n GTX1080Ti met 11GB vram een Gemma4 heeft draaien voor kleinere taken), dus dat gaat je lukken. Ik ben wel aan het kijken naar een MI210 van AMD op termijn... Dan kan de 5070Ti de kleinere modellen draaien en die MI210 (64GB vram) de grotere 
- Puff_Uncle
- Registratie: Februari 2020
- Laatst online: 20-10 14:38
oke was uiteindelijk echt simple met strata, krijg ongeveer 110tok/s en strata kwam zelf dat iq2_xs de beste fit zou zijn maar misschien dat ik dit weekend nog een hogere quant probeer want hij lijkt nu nog wel iets meer uit de tank te kunnen halen
- DeNachtwacht
- Registratie: December 2005
- Niet online
Prima setup om hem op IQ4_X_S te kunnen draaien met 256K context op zo'n 80-100 tokens/s. Daar kom ik uiteindelijk op uit met een RTX 5090 en daarnaast een 5060 Ti. Op die laatste zit wel de monitor ook aangesloten, waardoor de 5090 net iets meer vram voor AI kan claimen. Ik heb ook met de 5060 Ti erbij getest en geprobeerd naar de IQ4 / nvfp4 te gaan, maar dan zakt het toch al snel naar 30-40 tokens s/ en ook IQ4_X_S draait hier dan wat langzamer zelfs dan met alleen de 5090 (door flink minder cuda cores van de 5060 natuurlijk). Dat snelheidsverlies is me net ff te gortig, IQ4 met 50-60 was nog acceptabel geweest maar ook door flink meer energieverbruik door de 5060 Ti ernaast was het me niet waard om Q4 te kunnen draaien, dus ik ben hier uiteindelijk op uitgekomen.Puff_Uncle schreef op vrijdag 16 oktober 2026 @ 09:13:
[...]
welke quant draaien jullie? ff kijken of het op mijn dev pc met 32gb vram en 64gb ram
[ Voor 4% gewijzigd door DeNachtwacht op 16-10-2026 21:44 ]
- R3m3d7
- Registratie: Juli 2007
- Laatst online: 18-10 12:07
Ik bedoel dit natuurlijk relatief tov full percision. Als de full 4 bit is is een 3 bit daarvan natuurlijk veel beter dan een native 16 bit op 4 bit.Exirion schreef op dinsdag 13 oktober 2026 @ 18:42:
[...]
Dat kun je absoluut niet zo generaliseren. Sommige modellen verdragen quantisatie erg goed en DeepSeek V4 experts zijn bijvoorbeeld native getraind op 4-bit. Daarnaast wordt quantisatie ook beter, want er zijn hybride quantisatiemethoden waarbij bijvoorbeeld attention layers zo veel mogelijk intact worden gehouden terwijl de experts zich goed laten quantizen. Met geoptimaliseerde quantisatie kunnen modellen op 4-bit of 3-bit met minimale verliezen performen. DeepSeek V4 Flash (0731) doet het prima op 2.4bit. Qwen 3.8 Flash Next idem op 4-bit.
Beide zijn beduidend beter dan Qwen 3.8 27b. Die laatste is vooral zo populair omdat ie in het geheugen van populaire snelle GPU's past. Voor de grootte van het model is het indrukwekkend wat het kan, maar ik geef toch echt de voorkeur aan de andere genoemde modellen. Die draaien in grofweg 100GB geheugen. Met DeepSeek V4.1 en GLM 5.3 heb je weer een stuk meer nodig.
Bij Qwen 3.8 Flash Next zit overigens een aanzienlijke engram die vanaf SSD gelezen kan worden. Er zijn ook engines geoptimaliseerd voor bepaalde modellen te vinden, waarvan de meeste inmiddels expert streaming ondersteunen. LLMs draaiend met beperkt geheugen worden inmiddels steeds bruikbaarder
Een 200GB in 20GB gepropt zal meestal slechter zijn dan een model wat z’n level is begonnen als 20-30GB, dat was mijn punt.
- CT
- Registratie: September 2001
- Laatst online: 19:48
📱💻 🎮 ⌚🖥
goh, dat Strata werkt inderdaad gewoon  heb nu op een server die niks zat te doen (beetje krap met de VRAM was die voor serieuze modellen) het IQ3_XXS model daar op geladen (64GB RAM 20GB VRAM) maar met een 60tk/s doet het mn oude qwen 27b klusjes zonder problemen! scheelt weer een 40GB VRAM bak die naast mn buro stond te stampen.. heel bijzonder dit.. ga er wat meer induiken waarom dit zo goed werkt.. en de RAM van die bak naast mn buro maximaliseren, kan dan de Q4 versie ook is proberen.
- Felicia
- Registratie: Maart 2001
- Laatst online: 20-10 12:46
Ik was een flink eind op weg maar toen was ik door m'n verbruik bij Mistralmax3D schreef op maandag 19 oktober 2026 @ 17:31:
is er al iemand die Strata op de Intel Arc's aan de praat heeft (B70)
Het schijnt overigens wel te werken met WSL als je GPU passthrough goed aan de gang krijgt.
Ik draag een rok, wat is jouw excuus?
Of we volgen deze poging om Strata onder Windows aan de praat te krijgen Add Arc native Windows support by K8-and-a-half-1000 · Pull Request #1940 · Niko1221/Strata
- zx9r_mario
- Registratie: Oktober 2004
- Laatst online: 22:57
Met Strata haal ik op een AMD Vega II 16GB ca 42 tokens/sec (Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S 64k context)
2019 is callingzx9r_mario schreef op dinsdag 20 oktober 2026 @ 11:08:
Met Strata haal ik op een AMD Vega II 16GB ca 42 tokens/sec (Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S 64k context)
- Kuusj
- Registratie: April 2012
- Laatst online: 22:49
Ofwel varken in 't Limburgs

Met een Nvidia kaart misschien wel, maar met mijn RX9070XT heb ik (zoals gebruikelijk) toch weer de nodige issues met ROCm. Unsloth Qwen 3.8 Flash Next met een Q4XL quant.CT schreef op maandag 19 oktober 2026 @ 16:59:
goh, dat Strata werkt inderdaad gewoon
Ik heb 16GB vRAM en 96GB RAM, dus dat zou geen issue moeten zijn.. Krijg de volgende error:
Zelfs Claude Opus 5.5 op max thinking komt na een paar pogingen niet verder dan 'shit outta luck', je kunt Linux proberen maarja, of dat werkt was ook twijfelachtig. Ik heb ook in LM Studio wel gezeur met hipblaslt.server_exited (exit code 1): \engine\0.1.46-windows-x86_64-hip-rx9070\rocm\bin\libhipblaslt.dll(0x00007FF971BF0000) + 0x449FA byte(s), hipblaslt_debug_reload() + 0x342EA byte(s)
9800X3D - RX 9700XT
- CT
- Registratie: September 2001
- Laatst online: 19:48
📱💻 🎮 ⌚🖥
Ik draai het wel op linux, maar ook in een Docker, heb de source checkout en dan;
DOCKER_BUILDKIT=1 docker build -t strata:latest --build-arg CUDA_ARCHITECTURES=89 .
Deze start ik dan op en werkt alles prima, dus je kan in WSL misschien via docker proberen op windows? gebruik je toch linux zonder hele OS om te switchen
btw die 89 moet dan veranderd worden voor een code van AMD gok ik.
[ Voor 9% gewijzigd door CT op 20-10-2026 16:38 ]
- DeNachtwacht
- Registratie: December 2005
- Niet online
Hmm, ik vind Q4_X_L met jouw setup op zijn zachtst gezegd wat optimistisch. Ik heb “maar” 64gb ram, maar wel een rtx5090 er tegenover en ga niet hoger dan IQ4_X_S.Kuusj schreef op dinsdag 20 oktober 2026 @ 16:29:
Met een Nvidia kaart misschien wel, maar met mijn RX9070XT heb ik (zoals gebruikelijk) toch weer de nodige issues met ROCm. Unsloth Qwen 3.8 Flash Next met een Q4XL quant.
Ik heb 16GB vRAM en 96GB RAM, dus dat zou geen issue moeten zijn..
Met de helft aan vram en een minder krachtige gpu zou ik echt starten met Q2 om te zien hoe dat draait.
- Kuusj
- Registratie: April 2012
- Laatst online: 22:49
Ofwel varken in 't Limburgs
Dat kan, maar zó traag is de 9070XT nu ook weer niet. Belangrijker is dat hij hij niet start. Bij wijze van experiment heb ik GSQ-RCO Q2_0 gedownload, maar ook die faalt op launch. Ik ga mijn PC denk ik eens reinigen van alles AI en dan opnieuw proberen.DeNachtwacht schreef op dinsdag 20 oktober 2026 @ 17:03:
[...]
Hmm, ik vind Q4_X_L met jouw setup op zijn zachtst gezegd wat optimistisch. Ik heb “maar” 64gb ram, maar wel een rtx5090 er tegenover en ga niet hoger dan IQ4_X_S.
Met de helft aan vram en een minder krachtige gpu zou ik echt starten met Q2 om te zien hoe dat draait.
9800X3D - RX 9700XT
- Exirion
- Registratie: Februari 2000
- Laatst online: 03:42
Gadgetfetisjist
Daar is eigenlijk maar 1 uitleg voor mogelijk: blijkbaar is de set actieve experts (over x tokens) in het model vrij stabiel zodat er relatief weinig kopieeracties tussen GPU-geheugen en systeemgeheugen nodig zijn. Ik zou hier eigenlijk wel cijfers van willen zien.CT schreef op maandag 19 oktober 2026 @ 16:59:
heel bijzonder dit.. ga er wat meer induiken waarom dit zo goed werkt..
"Logica brengt je van A naar B, verbeelding brengt je overal." - Albert Einstein
- zx9r_mario
- Registratie: Oktober 2004
- Laatst online: 22:57
Heb deze getest met https://github.com/JustVugg/colibri. Met MiMo-V2.6 Flash (309B) haal ik 3 tokens/sec op I9 met 128 GB DDR4 en Vega II 16GB
- Martinspire
- Registratie: Januari 2003
- Laatst online: 22:58
Awesomeness

Ik twijfel momenteel of mijn AM4 met 128GB DDR4 nog wel geschikt gaat zijn voor een AI model in RAM icm de 5600G CPU met iGPU. Ik heb een aantal modellen geprobeerd, ook klein en ik moet zeggen dat de snelheid me telkens weer enorm tegenvalt. Nu kan ik er een GPU in zetten, maar die heeft weer weinig aan mijn 128GB. En als ik zo even kijk wat dat tegenwoordig kost, kan ik het eigenlijk beter verkopen en gewoon een stuk minder in prikken (volgens mij heb ik ergens nog 32gb liggen zelfs) en wellicht op een later moment nog een keer instappen. Of mijn GamePC gebruiken (met een 9070XT) voor het echt nodig is. Iemand enig idee of het de komende 2 jaar nog een beetje de moeite is met een dergelijk systeem? Ik zie nog wel eens wat dingen voorbij komen met intern geheugen, maar dat is volgens mij allemaal wel significant sneller dan wat ik erin heb zitten en ook daar is de performance niet verkeerd, maar met een GPU echt zoveel sneller. Ik had gehoopt met de iGPU uit te komen om het energieverbruik nog een beetje acceptabel te houden voor een lokaal gehost model die de hele dag beschikbaar is. Maar voorlopig zie ik daar eigenlijk weinig nut voor met de huidige staat. Als ik al vraag iets als "wat is het weer in <woonplaats>? dan duurt dat gewoon anderhalve minuut.
- DeNachtwacht
- Registratie: December 2005
- Niet online
Ding is een beetje dat het juist niet bepaald zuinig is wat je doet. Tijdens AI gebruik zal die CPU de volle 65 watt trekken om 3 tokens per seconde (ofzo?) te genereren.
In Strata trekt mijn 5090 zelf zo'n 200W volgens de monitor (natuurlijk zal de cpu ook wat trekken, maar die is vrij idle op dat moment, dus laten we het afronden naar 250W). Dat is met 100-120 tokens/s zo'n 2 watt per token, jij zit op 20 watt per token.
Je kan lokaal best leuke dingen met een 128GB DDR4 systeem als je er een GPU naast plaats, maar ja ik gok dat dat natuurlijk wat te gortig is. Op zich is de boel verkopen inderdaad misschien niet gek: als je die 128GB DDR4 verkoopt (DDR4-3200?) is daar wel weer een aardige 32GB DDR5 upgrade van te kopen, en met 64GB DDR5 + RX 9070 XT in je game pc kun je heel leuke dingen.
In Strata trekt mijn 5090 zelf zo'n 200W volgens de monitor (natuurlijk zal de cpu ook wat trekken, maar die is vrij idle op dat moment, dus laten we het afronden naar 250W). Dat is met 100-120 tokens/s zo'n 2 watt per token, jij zit op 20 watt per token
.Je kan lokaal best leuke dingen met een 128GB DDR4 systeem als je er een GPU naast plaats, maar ja ik gok dat dat natuurlijk wat te gortig is. Op zich is de boel verkopen inderdaad misschien niet gek: als je die 128GB DDR4 verkoopt (DDR4-3200?) is daar wel weer een aardige 32GB DDR5 upgrade van te kopen, en met 64GB DDR5 + RX 9070 XT in je game pc kun je heel leuke dingen.
[ Voor 4% gewijzigd door DeNachtwacht op 20-10-2026 22:59 ]